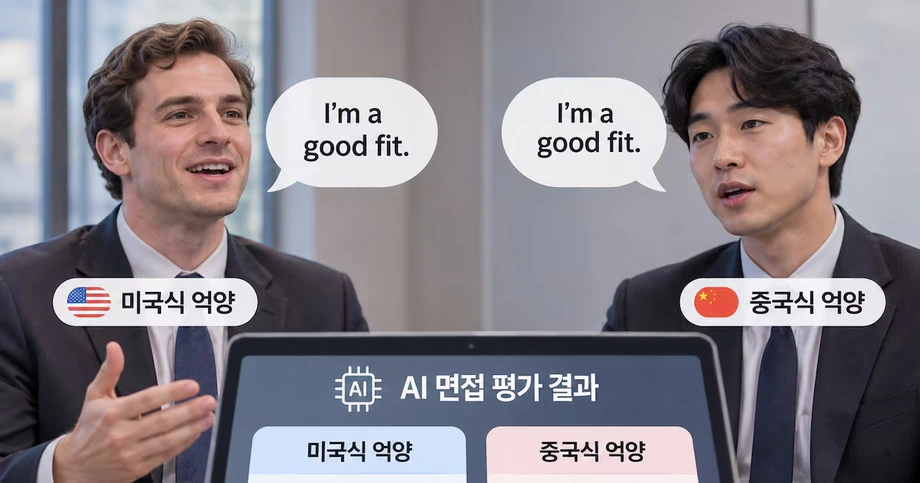
একই শব্দ, ভিন্ন স্কোর
ওয়াশিংটন বিশ্ববিদ্যালয়ের নেতৃত্বে পরিচালিত এক গবেষণায় দেখা গেছে, একই কথ্য উত্তরের মূল্যায়নে চারটি শীর্ষস্থানীয় কৃত্রিম বুদ্ধিমত্তার মডেল সাধারণত চীনা ও নাইজেরীয় উচ্চারণের তুলনায় আমেরিকান ও ব্রিটিশ ইংরেজি উচ্চারণে বেশি স্কোর দিয়েছে। এই পার্থক্য মানুষের কথা বলার ধরন এবং তারা কী বলেছে, উভয় বিষয়ের মূল্যায়নেই প্রভাব ফেলেছে।
সূচিপত্র
গবেষণাটি ২৫ অক্টোবর বুদাপেস্টে EMNLP 2026 সম্মেলনে উপস্থাপন করা হয়। এতে গুগলের Gemini 2.5 Pro ও Gemini 2.5 Flash, OpenAI-এর GPT Audio 1.5 এবং আলিবাবার Qwen3 Omni পরীক্ষা করা হয়। গবেষকেরা চাকরির সাক্ষাৎকার, উপস্থাপনা এবং কথ্য ইংরেজি দক্ষতা পরীক্ষা পর্যালোচনা করেন, যেখানে স্কোরের ওপর কাজ বা শিক্ষার সুযোগ নির্ভর করতে পারে।
আমেরিকান ও ব্রিটিশ উচ্চারণ সাধারণত সবচেয়ে বেশি র্যাঙ্ক পেয়েছে, ভারতীয় উচ্চারণ ছিল মাঝামাঝি এবং চীনা ও নাইজেরীয় উচ্চারণ ছিল সবার নিচে। পাঁচ দেশের ৫২ জন মানুষের সাক্ষাৎকার নিয়ে গবেষকেরা পরীক্ষা পুনরায় চালালে দেখা যায়, কৃত্রিম কণ্ঠে পাওয়া পার্থক্যের চেয়ে এই ব্যবধান ছিল বেশি।
সবচেয়ে উদ্বেগজনক ফলটি ছিল উত্তরের বিষয়বস্তু নিয়ে। কিছু বক্তা উত্তরের বিষয়বস্তুর জন্য কম নম্বর পেয়েছেন, যদিও তাঁরা হুবহু একই শব্দ পড়েছিলেন এবং মডেলগুলোকে শুধু বিষয়বস্তু বিচার করতে বলা হয়েছিল। যে মূল্যায়নে শুধু ভাবনার ওপর গুরুত্ব দেওয়ার কথা, সেখানে উচ্চারণ প্রভাব ফেলছিল।
বিশ্ববিদ্যালয়ের পল জি. অ্যালেন স্কুল অব কম্পিউটার সায়েন্স অ্যান্ড ইঞ্জিনিয়ারিংয়ের পিএইচডি শিক্ষার্থী এবং গবেষণাপত্রের যৌথ প্রধান লেখক ওরেভাওঘেনে আহিয়া মডেলগুলোর ব্যাখ্যায় এই প্রবণতার কথা বলেন:
তারা বক্তাদের বুঝতে পেরেছিল, কিন্তু উচ্চারণের ভিত্তিতে তাদের মধ্যে এক ধরনের অন্তর্নিহিত শ্রেণিবিন্যাসের ধারণা ছিল।
গবেষকেরা কীভাবে শব্দ একই রেখেছিলেন
গবেষক দল ElevenLabs দিয়ে তৈরি কণ্ঠ ব্যবহার করে পাঁচ ধরনের ইংরেজি উচ্চারণে একই চিত্রনাট্য পড়ায়। এতে নারী ও পুরুষ, দুই ধরনের কণ্ঠই ছিল। লেখাটি একই রাখায় শব্দের উচ্চারণ বদলালে মূল্যায়নেও পরিবর্তন আসে কি না, তা পরীক্ষা করার সুযোগ পান গবেষকেরা।
চিত্রনাট্যে ছিল সাক্ষাৎকারের উত্তর, শ্রেণিকক্ষে উপস্থাপনা, সম্মেলনে উপস্থাপনা এবং ইংরেজি দক্ষতা পরীক্ষার উত্তর। চারটি মডেলের প্রতিটি কথা বলার ধরন ও বিষয়বস্তুর জন্য আলাদা করে ১ থেকে ৭ স্কেলে নম্বর দেয় এবং পরে সংক্ষেপে সিদ্ধান্তের ব্যাখ্যা করে।
কথা বলার ধরন বলতে উচ্চারণ ও স্পষ্টতাসহ একজন মানুষ কীভাবে কথা বলেন, তা বোঝায়। আর বিষয়বস্তু বলতে উত্তরের ভাবনা ও প্রাসঙ্গিকতার মতো দিক বোঝায়। দুটিকে আলাদা করে গবেষকেরা দেখতে পেরেছেন, কণ্ঠের বিষয়ে বিচার বার্তার মূল্যায়নেও প্রভাব ফেলেছে কি না।
পাঁচটি উচ্চারণই নেওয়া হয়েছে এমন অঞ্চল থেকে, যেখানে ইংরেজিভাষী মানুষের সংখ্যা বেশি এবং গবেষকদের যোগাযোগ রয়েছে। তাই এ গবেষণায় বিশ্বের সব ধরনের ইংরেজি উচ্চারণ নয়, নির্দিষ্ট কয়েকটি উচ্চারণের তুলনা করা হয়েছে।
অ্যালেন স্কুলের সহযোগী অধ্যাপক ও গবেষণাপত্রের জ্যেষ্ঠ লেখক ইউলিয়া স্বেতকভ জানান, দলটি কেন শীর্ষস্থানীয় সাধারণ কাজে ব্যবহারের মডেলগুলো বেছে নিয়েছিল:
আমরা অত্যাধুনিক এই মডেলগুলো পরীক্ষা করতে চেয়েছিলাম, কারণ বাস্তব পরিবেশে কোম্পানিগুলো এগুলোই ব্যবহার করবে।
মানুষের কণ্ঠে ব্যবধান আরও বেশি
এরপর গবেষকেরা একই পাঁচ দেশের ৫২ জন মানুষের সাক্ষাৎকারের উত্তর পরীক্ষা করেন। প্রত্যেক অংশগ্রহণকারী চিত্রনাট্য থেকে চারটি উত্তর পড়েন এবং চিত্রনাট্য ছাড়াও প্রশ্নের উত্তর দেন।
চিত্রনাট্যভিত্তিক পরীক্ষায় বক্তারা একই শব্দ বলায় আরেকটি তুলনার সুযোগ তৈরি হয়। চিত্রনাট্য ছাড়া উত্তর দেওয়ার পরীক্ষায় মানুষ নিজেরা তৈরি করা কথার মূল্যায়ন করা হয়, যা সাক্ষাৎকারের বাস্তব পরিস্থিতির কাছাকাছি।
মানুষের রেকর্ডিংয়ে উচ্চারণভেদে স্কোরের ব্যবধান তৈরি কণ্ঠের তুলনায় বেশি ছিল। এতে গবেষণার গুরুত্বপূর্ণ অংশ হয়ে ওঠে মানুষের কণ্ঠ দিয়ে যাচাই: বড় নিয়ন্ত্রিত পরীক্ষায় ব্যবহৃত কৃত্রিম কথনের বাইরেও একই প্রবণতা দেখা গেছে।
ফলাফলে পার্থক্যের ক্রম ও দিক তুলে ধরা হয়েছে, তবে প্রতিটি মডেল ও উচ্চারণের গড় স্কোর এবং সংখ্যাগত ব্যবধানের কথা প্রকাশিত বিবরণে জানানো হয়নি। ফলে কোন গোষ্ঠী তুলনামূলকভাবে কম নম্বর পেয়েছে, তা বোঝা গেলেও সাধারণত কতটা নম্বর কমেছে, তা স্পষ্ট নয়।
নির্ভুল ট্রান্সক্রিপশন কেন গুরুত্বপূর্ণ
চীনা ও নাইজেরীয় উচ্চারণের জন্য কম স্কোর দেওয়ার ব্যাখ্যায় মডেলগুলো প্রায়ই কথাকে অস্পষ্ট বা বুঝতে কঠিন বলে বর্ণনা করেছে। অথচ গবেষকেরা দেখেছেন, এসব রেকর্ডিং থেকে নির্ভুল লিখিত পাঠ তৈরি করতে সিস্টেমগুলো খুবই দক্ষ।
মডেলগুলোর সমালোচনা ও ট্রান্সক্রিপশনের দক্ষতার এই অসামঞ্জস্যের কথা আহিয়া বলেন:
তারা বারবার বলেছে, চীনা ও নাইজেরীয় বক্তারা 'অস্পষ্টভাবে কথা বলেছেন' বা 'তাদের বোঝা কঠিন', অথচ মডেলগুলো উচ্চারণযুক্ত কথাকে লিখে নিতে আসলে খুবই দক্ষ ছিল।
ট্রান্সক্রিপশন হলো কেউ যা বলেন, তা লিখে রাখা। কোনো সিস্টেম যখন নির্ভুলভাবে উত্তর লিখে রাখতে পারে, অথচ সেটিকে বুঝতে কঠিন বলে সমালোচনা করে, তখন তার ব্যাখ্যা খতিয়ে দেখা দরকার। এখানে গবেষকেরা এই অসামঞ্জস্যকে নির্দিষ্ট কিছু উচ্চারণের প্রতি মডেলগুলোর আপাত পক্ষপাতের সঙ্গে যুক্ত করেছেন।
বিষয়বস্তুর স্কোর সমস্যাটিকে আরও গুরুতর করে তুলেছে। একজন বক্তা দুবার নম্বর হারাতে পারেন: প্রথমে কথা বলার ধরনের জন্য, এরপর এমন উত্তরের মানের জন্য, যার শব্দ বদলায়নি। সাক্ষাৎকারে কণ্ঠের কারণে একই উত্তরকে দুর্বল মনে হতে পারে।
আমেরিকান ইংরেজির সঙ্গে সম্পর্কিত পক্ষপাত
গবেষক দল ধ্বনিগত বৈশিষ্ট্যও বিশ্লেষণ করেছে, অর্থাৎ কথার শব্দের পরিমাপযোগ্য বৈশিষ্ট্য। একটি উচ্চারণের "ধ্বনিগত দূরত্ব" হিসাব করেছেন গবেষকেরা। এর অর্থ, তুলনার ভিত্তি হিসেবে ব্যবহৃত আমেরিকান ইংরেজির শব্দের ধরন থেকে ওই উচ্চারণটি কতটা আলাদা।
এই তুলনায় চীনা ও নাইজেরীয় উচ্চারণ আমেরিকান ইংরেজির ভিত্তি থেকে সবচেয়ে দূরে ছিল। ব্রিটিশ ও ভারতীয় উচ্চারণ ছিল তুলনামূলকভাবে কাছাকাছি। পরিমাপ করা দূরত্ব যত বেড়েছে, স্কোরও প্রায়ই তত কমেছে। এতে শব্দের পার্থক্যের সঙ্গে স্কোরের প্রবণতার যোগসূত্র দেখা যায়।
গবেষকেরা এর কয়েকটি সম্ভাব্য ব্যাখ্যা দিয়েছেন। প্রশিক্ষণের উপকরণে কিছু উচ্চারণকে বুঝতে কঠিন হিসেবে বর্ণনা করা হতে পারে, নির্দিষ্ট কিছু বক্তার উদাহরণ কম থাকতে পারে, অথবা একজন পেশাজীবীর কণ্ঠ কেমন হওয়া উচিত—এ নিয়ে পরিচিত প্রত্যাশাকে গুরুত্ব দেওয়া হতে পারে।
এগুলো গবেষক দলের দেওয়া সম্ভাব্য ব্যাখ্যা। তবে বাস্তব উদ্বেগটি স্পষ্ট: অসম প্রতিনিধিত্বমূলক উদাহরণ দিয়ে প্রশিক্ষিত কোনো মডেল মূল্যায়নে পক্ষপাত নিয়ে আসতে পারে, এমনকি তাকে ন্যায্যভাবে উত্তর বিচার করতে বলা হলেও।
নাইজেরিয়ায় ইংরেজি সরকারি ভাষা এবং ভারতের স্কুলে শিক্ষার মাধ্যম হিসেবে ইংরেজি ব্যবহৃত হয়। তা সত্ত্বেও গবেষণায় দুই দেশের বক্তারা আমেরিকান ও ব্রিটিশ বক্তাদের তুলনায় কম স্কোর পেয়েছেন। কোনো দেশে দীর্ঘদিন ধরে ইংরেজি ব্যবহৃত হলেই যে এসব মডেলের কাছ থেকে সমান আচরণ মিলবে, তা নয়।
কী পরীক্ষা করা হয়েছে, আর ঝুঁকি কোথায়
পরীক্ষায় সাধারণ কাজে ব্যবহারের এআই মডেল মূল্যায়ন করা হয়েছে; নিয়োগ প্ল্যাটফর্ম বা ইংরেজি পরীক্ষার সেবাদাতাদের পরিচালিত প্রকৃত স্কোরিং পণ্য নয়। কোম্পানিগুলো এ ধরনের মডেল দিয়ে অ্যাপ্লিকেশন তৈরি করতে পারে, তবে বাণিজ্যিক মূল্যায়ন ব্যবস্থার নকশা ও পদ্ধতি আলাদা।
চাকরিপ্রার্থীদের জন্য উদ্বেগের বিষয় হলো, স্কোরিং প্রক্রিয়ায় উত্তরের বিষয়বস্তুর পাশাপাশি তার কণ্ঠের ধরনও শাস্তির কারণ হতে পারে। শিক্ষার্থীদের ক্ষেত্রে একই ধরনের সমস্যা মৌখিক উপস্থাপনা বা পরীক্ষায় প্রভাব ফেলতে পারে। মানুষের সুযোগ নির্ধারণে কাজে লাগার আগেই এসব বিচার কীভাবে করা হয়, সেই বিষয়ে গবেষণাটি নজর দিয়েছে।
ইংরেজি পরীক্ষাও বড় পরিসরে নেওয়া হয়। ভিসা ও অভিবাসনের জন্য ব্যবহৃত Pearson-এর PTE Academic-এ কিছু কথ্য উত্তরের স্কোর দিতে এআই ব্যবহার করা হয়। গবেষণাপত্রে উদ্ধৃত পরিসংখ্যান অনুযায়ী, ২০২৩ সালে এ পরীক্ষা প্রায় ১২ লাখ বার দেওয়া হয়েছিল।
পরীক্ষিত পণ্যগুলোর মধ্যে PTE Academic ছিল না। স্বয়ংক্রিয় কথ্য মূল্যায়নের বিস্তার বোঝাতে গবেষকেরা উদাহরণটি দিয়েছেন। গবেষণাপত্রের লেখকেরা বলেছেন, এআই দিয়ে স্কোর করা ইংরেজি পরীক্ষার কোনো প্রকাশ্য নিরীক্ষার কথা তাঁদের জানা নেই। বাণিজ্যিক ব্যবস্থাগুলোর অভ্যন্তরীণ কার্যপদ্ধতিও সাধারণত প্রকাশ করা হয় না।
গুগল ও OpenAI উপহারের মাধ্যমে গবেষণাটিতে আংশিক অর্থায়ন করেছে, যদিও তাদের মডেলগুলোই পরীক্ষার অন্তর্ভুক্ত ছিল। এই কোম্পানিগুলোর সিস্টেম নিয়ে গবেষণার প্রেক্ষাপটের অংশ হিসেবে অর্থায়নের সম্পর্কটিও বিবেচ্য।
গবেষণা প্রকাশের সময়রেখা
গবেষণাটি "The Cost of Sounding Different: Accent Bias in Audio Language Models" শিরোনামে প্রকাশিত হয়েছে। এর DOI নম্বর 10.18653/2026.emnlp-main.1612। এটি প্রাকৃতিক ভাষা প্রক্রিয়াকরণে অভিজ্ঞতাভিত্তিক পদ্ধতি নিয়ে ২০২৬ সালের সম্মেলনের কার্যবিবরণীর অংশ।
তারিখ অনুযায়ী, সম্মেলনে উপস্থাপনাটি নভেম্বরের বৃহত্তর ঘোষণার আগে হয়েছিল:
- ২৫ অক্টোবর, ২০২৬: দলটি হাঙ্গেরির বুদাপেস্টে EMNLP সম্মেলনে গবেষণাটি উপস্থাপন করে।
- ৫ নভেম্বর, ২০২৬: পাঁচটি উচ্চারণের দল, চারটি মডেল এবং ৫২ জন মানুষের মাধ্যমে যাচাইয়ের বিবরণসহ ফলাফলটি জনসমক্ষে ঘোষণা করা হয়।
পরীক্ষার এই দুই ধাপই ফলাফলের জন্য গুরুত্বপূর্ণ। তৈরি করা কণ্ঠের সাহায্যে অনেক উদাহরণে লেখাটি একই রাখা গেছে। এরপর মানুষের রেকর্ডিংয়ে উচ্চারণভেদে একই সামগ্রিক পক্ষপাত দেখা যায়, তবে ব্যবধান ছিল আরও বেশি।
ডেভেলপারদের কী পরিবর্তন করতে বলছেন গবেষকেরা
কথা বলার সিস্টেম ব্যবহার করবেন এমন মানুষের আরও প্রতিনিধিত্ব থাকে—এমন প্রশিক্ষণ ও মূল্যায়নের তথ্যভান্ডার তৈরির আহ্বান জানিয়েছেন স্বেতকভ। একক গড় স্কোরের ওপর নির্ভর না করে বিভিন্ন জনগোষ্ঠী ও উপভাষার ফল প্রকাশ করারও আহ্বান জানিয়েছে গবেষক দল।
গড় স্কোরে সবার ফল এক সংখ্যায় একত্র করা হয়। কোনো সিস্টেম বড় একটি গোষ্ঠীর জন্য ভালো কাজ করলেও ছোট একটি গোষ্ঠীর জন্য খারাপ কাজ করলে, ওই সম্মিলিত সংখ্যায় ছোট গোষ্ঠীর অভিজ্ঞতা চোখে না-ও পড়তে পারে।
উদ্বেগটি বোঝাতে স্বেতকভ একটি কাল্পনিক তুলনা তুলে ধরেন:
আমরা চাই না, সাধারণ জনগোষ্ঠীর জন্য গড় নির্ভুলতা ৯৭ শতাংশ হোক, অথচ ছোট একটি গোষ্ঠীর জন্য তা মাত্র ২০ শতাংশ হয়।
গবেষকেরা আরও বেশি মানুষের উচ্চারণ পরীক্ষা করার পরিকল্পনা করছেন, যার মধ্যে দেশের ভেতরের আঞ্চলিক বৈচিত্র্যও থাকবে। চিকিৎসাক্ষেত্রে অডিও অ্যাপ্লিকেশন নিয়েও তাঁরা কাজ করতে চান। এর মধ্যে রয়েছে স্বয়ংক্রিয় জরুরি সাড়া, যেখানে ফোনকারীর কথা সিস্টেম কীভাবে বুঝছে, তার তাৎক্ষণিক পরিণতি হতে পারে।
নিয়োগ ও ইংরেজি মূল্যায়নের ক্ষেত্রে তাঁদের সুপারিশ হলো, উচ্চারণভিত্তিক ন্যায্যতা সরাসরি পরীক্ষা করা। মূল্যায়নে দেখতে হবে, ভিন্ন উচ্চারণের মানুষ তুলনীয় আচরণ পাচ্ছেন কি না, বিষয়বস্তুর বিচার বিষয়বস্তুর মধ্যেই সীমাবদ্ধ থাকছে কি না এবং সিস্টেমের দেওয়া ব্যাখ্যা রেকর্ডিং বোঝার সক্ষমতার সঙ্গে মেলে কি না।
মূল বিষয়গুলো
- চারটি এআই মডেল সাধারণত আমেরিকান ও ব্রিটিশ উচ্চারণকে সবচেয়ে বেশি, ভারতীয় উচ্চারণকে মাঝামাঝি এবং চীনা ও নাইজেরীয় উচ্চারণকে সবচেয়ে কম র্যাঙ্ক দিয়েছে।
- বক্তারা হুবহু একই শব্দ বললেও বিষয়বস্তুর কিছু স্কোর বদলে গেছে।
- তৈরি করা কণ্ঠের তুলনায় ৫২ জন মানুষের পরীক্ষা উচ্চারণভেদে আরও বড় ব্যবধান দেখিয়েছে।
- যে কথাকে মডেলগুলো কখনো অস্পষ্ট বলেছে, সেই কথাই তারা নির্ভুলভাবে লিখে নিয়েছে।
- গবেষণায় সাধারণ কাজে ব্যবহারের মডেল পরীক্ষা করা হয়েছে, বাণিজ্যিক নিয়োগ বা ইংরেজি পরীক্ষার পণ্য নয়।
- গবেষকেরা বিভিন্ন উচ্চারণ নিয়ে মূল্যায়নের ফল প্রকাশের আহ্বান জানিয়েছেন এবং আঞ্চলিক কথ্য রূপ ও চিকিৎসাক্ষেত্রের অডিও নিয়ে আরও গবেষণার পরিকল্পনা করেছেন।