কার্যকর জিপিইউ এবং থ্রুপুটে ৫% এগিয়ে থাকার দাবি
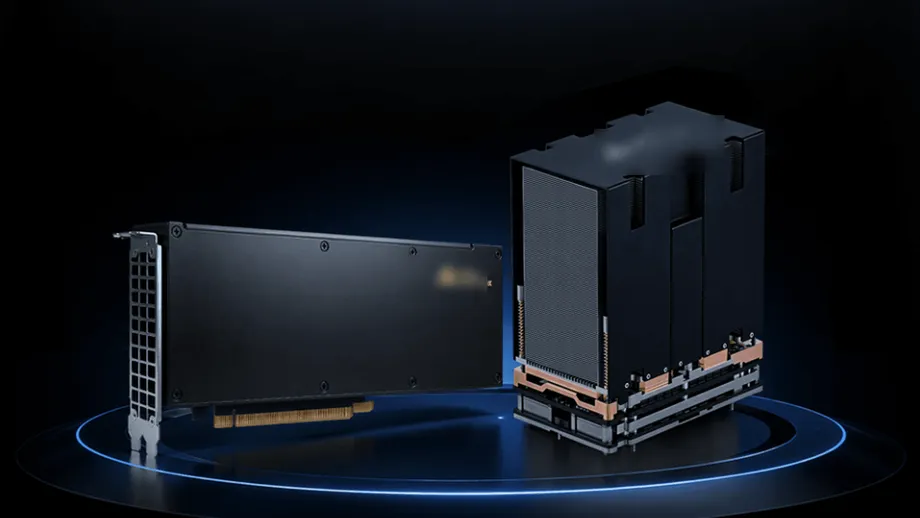
সাংহাইয়ে Tiangai 300 গ্রাফিকস প্রসেসর প্রকাশ্যে প্রদর্শন করেছে Iluvatar CoreX। Nvidia-র H200-এর চীনা বিকল্প হিসেবে এটি উপস্থাপন করে প্রতিষ্ঠানটি; তৃতীয় পক্ষের একটি ইনফারেন্স পরীক্ষায় ৫% এগিয়ে থাকার দাবিও করেছে। ২০২৬ সালের ২৮ অক্টোবরের মিডিয়া উন্মুক্ত অনুষ্ঠানে প্রতিষ্ঠানটি আটটি জিপিইউযুক্ত একটি প্রশিক্ষণ ব্যবস্থা দেখায় এবং ১৪৪টি জিপিইউ ও ১৮টি সিপিইউসহ একটি র্যাকের বিবরণ দেয়।
সূচিপত্র
- কার্যকর জিপিইউ এবং থ্রুপুটে ৫% এগিয়ে থাকার দাবি
- H200-এর সঙ্গে তুলনায় কী মাপা হয়েছে
- দীর্ঘ নথি এবং দ্রুত প্রথম উত্তর
- প্রশিক্ষণের ফলাফলে Nvidia-র ভিন্ন রেফারেন্স
- জুলাইয়ের উন্মোচন থেকে অক্টোবরের প্রদর্শনী
- ১৪৪টি জিপিইউ নিয়ে তৈরি র্যাক
- বিভিন্ন চিপের মধ্যে এআই কাজ ভাগ করে নেওয়া
- সফটওয়্যারের দাবি স্থাপনের সময় কমানোর লক্ষ্য
- রোবটের ক্ষেত্রেও প্রস্তাব নিয়ে এসেছে TY1200
- মূল বিষয়গুলো
Iluvatar CoreX-এর ভাষ্য অনুযায়ী, শিরোনামে উল্লেখ করা তুলনাটি এসেছে Shanghai Electric Group-এর জুলাইয়ে সম্পন্ন করা পরীক্ষা থেকে। বৃহৎ ভাষা মডেল প্রক্রিয়াকরণের দুটি ধাপ আলাদা করে পরিচালিত একটি ব্যবস্থায় Tiangai 300-এর এন্ড-টু-এন্ড থ্রুপুট ছিল H200-এর ১.০৫ গুণ, ফলাফলকে প্রতি কার্ডের হিসাবে রূপান্তর করার পর।
থ্রুপুট বলতে নির্দিষ্ট সময়ে একটি ব্যবস্থা কতটা কার্যকর কাজ সম্পন্ন করে, তা বোঝায়। চ্যাটবটের ক্ষেত্রে এর অর্থ হতে পারে, প্রতি সেকেন্ডে কতটি লেখার অংশ তৈরি হচ্ছে। পরীক্ষার শর্তে রেফারেন্স পারফরম্যান্সের ১.০৫ গুণ ফল মানে ৫% বেশি আউটপুট।
প্রতিষ্ঠানটি Tiangai 300-কে পরীক্ষায় পরিমাপ করা পারফরম্যান্সে H200-এর সমপর্যায়ে পৌঁছানো প্রথম চীনা সাধারণ উদ্দেশ্যের জিপিইউ বলে বর্ণনা করেছে। অক্টোবরে তাদের প্রদর্শনীতে ভাষা মডেল, ছবি তৈরি ও ভিডিও তৈরির ক্ষেত্রেও তুলনা দেখানো হয়। আরেকটি প্রশিক্ষণ প্রদর্শনীতে রেফারেন্স হিসেবে Nvidia-র H100 ব্যবহার করা হয়।
অনুষ্ঠানে শুধু চিপের বৈশিষ্ট্যই উপস্থাপন করা হয়নি। Iluvatar CoreX কার্ড, সার্ভার, উচ্চ ঘনত্বের র্যাক নকশা, সফটওয়্যার টুল এবং বিভিন্ন ধরনের প্রসেসরের মধ্যে এআই কাজ ভাগ করে নেওয়ার একটি পদ্ধতি দেখায়। প্রতিষ্ঠানটির বাণিজ্যিক দাবি, এসব উপাদান একত্রে কম খরচে এবং কম অপেক্ষায় কার্যকর এআই আউটপুট দিতে পারে।
H200-এর সঙ্গে তুলনায় কী মাপা হয়েছে
Shanghai Electric Group-এর জুলাইয়ের পরীক্ষায় প্রিফিল ও ডিকোড ধাপ আলাদা করে চালানো হয়েছিল, যা সংক্ষেপে PD separation নামে পরিচিত। প্রিফিল হলো সেই ধাপ, যখন ভাষা মডেল ব্যবহারকারীর অনুরোধ এবং সহায়ক উপকরণ পড়ে। ডিকোড হলো উত্তর তৈরির ধাপ, যেখানে মডেল একবারে একটি টোকেন তৈরি করে। টোকেন হলো লেখার ছোট ছোট অংশ, যেগুলোতে এআই ব্যবস্থা পাঠ্যকে ভাগ করে।
এই ধাপগুলো আলাদা করলে পড়া ও লেখার কাজে ভিন্নভাবে সম্পদ বরাদ্দ করা যায়। তাই Tiangai 300-এর ফল নির্দিষ্ট একটি স্থাপন বিন্যাসের সঙ্গে সম্পর্কিত; মোট পারফরম্যান্সকে একটি কার্ডের সমতুল্য হিসাবে প্রকাশ করা হয়েছে।
শিরোনামে উল্লেখ করা তৃতীয় পক্ষের পরীক্ষার বিস্তারিত পদ্ধতি, মডেলের তালিকা বা কাজের শর্ত Iluvatar CoreX প্রকাশ করেনি। ফলাফল স্বাধীনভাবে পুনরুৎপাদনের জন্য এসব তথ্যের পাশাপাশি রূপান্তরের হিসাব ও সফটওয়্যারের সেটিংস জানা প্রয়োজন। খরচের তুলনার বিস্তারিত হিসাবও প্রকাশিত হয়নি। পাশাপাশি, পৃথক কার্ড ও সম্পূর্ণ র্যাকের মেমোরির পরিমাণ স্পষ্ট করা দরকার।
পারফরম্যান্স ল্যাবের নামসহ প্রদর্শনীগুলো প্রতিষ্ঠানটির দাবির আরও বিস্তারিত চিত্র তুলে ধরে। সেখানে মাল্টিমিডিয়া তৈরি থেকে সামান্য উন্নতি এবং সুপারিশের থ্রুপুটে বড় বৃদ্ধি পর্যন্ত, বিভিন্ন কাজে ভিন্ন ভিন্ন উন্নতির কথা বলা হয়েছে। ক্রেতার জন্য প্রাসঙ্গিক তুলনা হলো, তাদের নিজস্ব পরিষেবায় যে কাজটি চালানো হয়, সেটি।
দীর্ঘ নথি এবং দ্রুত প্রথম উত্তর
প্রতিষ্ঠানটির ল্যাবের তথ্য অনুযায়ী, 64K কনটেক্সট দৈর্ঘ্যে Tiangai 300-এর অ্যাটেনশন পারফরম্যান্স H200-এর ১.০৫ গুণে পৌঁছেছে। অ্যাটেনশন হলো এমন প্রক্রিয়া, যা মডেলকে ইনপুটের কোন অংশগুলো পরস্পরের সঙ্গে সম্পর্কিত তা বুঝতে সাহায্য করে। 64K কনটেক্সট দৈর্ঘ্য মানে মডেলটি প্রায় ৬৪ হাজার টোকেন নিয়ে কাজ করছে।
একই কনটেক্সট পরিসরে GLM-5.3 মডেলে, সমতুল্য ব্যবহার-অভিজ্ঞতা বজায় রেখে H200-এর ১.১৫ গুণ থ্রুপুটের দাবি করেছে Iluvatar CoreX। পরীক্ষিত মিক্সচার-অফ-এক্সপার্টস কাজের ক্ষেত্রে এটি ১৫% বৃদ্ধি। মিক্সচার-অফ-এক্সপার্টস মডেল প্রতিটি টোকেনের জন্য সব নেটওয়ার্ক ব্যবহার না করে নির্বাচিত বিশেষজ্ঞ নেটওয়ার্কে কাজ পাঠায়।
8K থেকে 128K পর্যন্ত কনটেক্সটের এআই এজেন্টের কাজে, প্রথম আউটপুট টোকেনের জন্য অপেক্ষার সময় প্রায় ১০% থেকে ৩০% কমেছে বলে জানিয়েছে প্রতিষ্ঠানটি। দীর্ঘ নথি পড়া বা জটিল অনুরোধ প্রক্রিয়াকরণের পর সহকারীর উত্তর শুরু হওয়ার জন্য অপেক্ষারত ব্যবহারকারীর কাছে এই পরিমাপটি গুরুত্বপূর্ণ।
প্রদর্শনীর আরেকটি অংশে ছিল ছবি ও ভিডিও তৈরি। H200-এর তুলনায় মাল্টিমোডাল জেনারেশন থ্রুপুট প্রায় ২% থেকে ৫% বেড়েছে বলে জানিয়েছে প্রতিষ্ঠানটি। অনলাইন সার্চ, বিজ্ঞাপন ও সুপারিশের কাজে তাদের দাবি, সুপারিশ ইনফারেন্স থ্রুপুট ২১% বেশি এবং হালকা গণনার ল্যাটেন্সি ২৬% কম।
প্রশিক্ষণের ফলাফলে Nvidia-র ভিন্ন রেফারেন্স
প্রশিক্ষণ প্রদর্শনীতে প্রায় ৩২ বিলিয়ন প্যারামিটারের মডেল Qwen3-32B আট-জিপিইউ সার্ভারে চালানো হয়। প্যারামিটার হলো সংখ্যাগত মান, যেগুলো প্রশিক্ষণের সময় মডেল ধরন শেখার জন্য সমন্বয় করে। Iluvatar CoreX-এর দাবি, প্রতি কার্ডে কার্যকর থ্রুপুট Nvidia-র H100-এর ১.৩৩ গুণে পৌঁছেছে।
অতএব ওই প্রশিক্ষণ প্রদর্শনীতে দাবি করা এগিয়ে থাকার হার ছিল ৩৩%, যেখানে তুলনার চিপ ছিল H100। অনুষ্ঠানের অন্য অংশে ইনফারেন্সের ফলাফলের জন্য H200 ব্যবহার করা হয়েছে। সংখ্যাগুলো বুঝতে এই দুই রেফারেন্স পণ্যকে আলাদা রাখা জরুরি।
প্রশিক্ষণ ব্যবস্থা FP8 নির্ভুলতায় কাজ করেছে। FP8-এ সংখ্যা আট বিটে সংরক্ষণ করা হয়, ফলে বেশি বিট ব্যবহার করা ফরম্যাটের তুলনায় কম তথ্য স্থানান্তর ও প্রক্রিয়াকরণ করতে হয়। শেখার মান ধরে রাখতে এআই প্রশিক্ষণ সফটওয়্যারকে এই কম নির্ভুলতার ব্যবহার সতর্কভাবে পরিচালনা করতে হয়।
পূর্ণ লোডে দীর্ঘ সময় কাজের সময় ধাপ সম্পন্নের সময়ের তারতম্য ০.৪৩% ছিল বলে জানিয়েছে Iluvatar CoreX; Hopper-ভিত্তিক একটি রেফারেন্স ব্যবস্থায় তা ছিল ০.৭৬%। ধাপের সময় বলতে বারবার সম্পাদিত একটি কাজের একক সম্পন্ন করতে প্রয়োজনীয় সময় বোঝায়। সময়ের ধারাবাহিকতা বেশি থাকলে ব্যস্ত একটি ব্যবস্থা কতটা কাজ শেষ করতে পারবে, তা পরিচালকদের পরিকল্পনা করতে সুবিধা হয়।
জুলাইয়ের উন্মোচন থেকে অক্টোবরের প্রদর্শনী
২০২৬ সালের জুলাইয়ে World Artificial Intelligence Conference-এ আনুষ্ঠানিকভাবে Tiangai 300 উন্মোচন করা হয়। এতে প্রতিষ্ঠানটির Tianshu আর্কিটেকচার ব্যবহার করা হয়েছে, রয়েছে নতুন প্রজন্মের Tensor Core এবং এর গ্রাফিকস মেমোরি ১৪৪ জিবি বলে উল্লেখ করা হয়েছে।
প্রসেসরটি স্কেলার, ভেক্টর ও টেনসর অপারেশন সমর্থন করে। সহজ ভাষায়, এগুলো যথাক্রমে একক সংখ্যা, সংখ্যার দল এবং বড় গাণিতিক অ্যারে নিয়ে কাজ করে। সমর্থিত সংখ্যাগত ফরম্যাটের মধ্যে রয়েছে FP4, FP8, FP16 এবং BF16; এতে সফটওয়্যার ডেভেলপাররা গতি, মেমোরি ব্যবহার ও সংখ্যাগত নির্ভুলতার জন্য বিভিন্ন বিকল্প পান।
প্রতিষ্ঠানটির বর্ণনা অনুযায়ী, কয়েক মাসজুড়ে পণ্যটির গুরুত্বপূর্ণ মাইলফলকগুলো হলো:
- জুলাই ২০২৬: World Artificial Intelligence Conference-এ Tiangai 300 উন্মোচন করা হয়।
- জুলাই ২০২৬: H200-এর সঙ্গে থ্রুপুট তুলনার জন্য উল্লেখ করা তৃতীয় পক্ষের পরীক্ষা সম্পন্ন করে Shanghai Electric Group।
- অক্টোবরের মিডিয়া অনুষ্ঠানের আগে: China International Industry Fair-এ IXL144 র্যাকের নকশা দেখানো হয়।
- ২৮ অক্টোবর ২০২৬: সাংহাইয়ে গণমাধ্যমের জন্য Tiangai 300 হার্ডওয়্যারের সরাসরি প্রদর্শনী উন্মুক্ত করে Iluvatar CoreX।
অক্টোবরের অনুষ্ঠান পণ্যের উপস্থাপনাকে আর্কিটেকচারের বিবরণ থেকে নাম উল্লেখ করা কাজ চালানো ব্যবস্থার দিকে নিয়ে যায়। প্রতিষ্ঠানটির বর্ণনা অনুযায়ী, স্থাপনের পরিসর এখন একক অ্যাক্সিলারেটর কার্ড থেকে আট কার্ডের সার্ভার এবং বড় IXL144 ব্যবস্থা পর্যন্ত বিস্তৃত।
১৪৪টি জিপিইউ নিয়ে তৈরি র্যাক
Iluvatar CoreX-এর তথ্য অনুযায়ী, IXL144-এ একটি স্ট্যান্ডার্ড র্যাকে ১৪৪টি জিপিইউ ও ১৮টি সিপিইউ রয়েছে, আর সম্মিলিত জিপিইউ মেমোরি প্রায় ১০.১ টেরাবাইট। প্রতিষ্ঠানটি একে একক র্যাকে রাখা শিল্পের সর্বোচ্চ ঘনত্বের জিপিইউ সুপারনোড বলে বর্ণনা করেছে। সুপারনোডে অনেক প্রসেসরকে কাছাকাছি সংযুক্ত করা হয়, যাতে তারা বড় কাজ একসঙ্গে করতে পারে।
প্রতি Tiangai 300-এর ১৪৪ জিবি স্পেসিফিকেশন এবং র্যাকের মোট ১০.১ টেরাবাইটের হিসাবের মধ্যে সম্পর্ক বুঝতে আরও স্পষ্ট বিন্যাসের বিবরণ দরকার। ১৪৪টি কার্ডকে ১৪৪ জিবি দিয়ে গুণ করলে হয় ২০,৭৩৬ জিবি, যদিও ধারণক্ষমতা গণনার পদ্ধতিতে পার্থক্য থাকতে পারে। র্যাকের বিবরণে কার্ডের বিন্যাস এবং কাজের জন্য ব্যবহারযোগ্য মেমোরির পরিমাণ উল্লেখ করা প্রয়োজন।
প্রধান আন্তর্জাতিক ব্যবস্থার তুলনায় প্রতি ১০ লাখ কার্যকর টোকেনের খরচ প্রায় ৪০% কমানো সম্ভব বলে অনুমান করেছে Iluvatar CoreX। কার্যকর টোকেন বলতে উপযোগী কাজ হিসেবে গণনা করা আউটপুট বোঝায়। এআই পরিষেবা বিক্রি করা অপারেটরদের জন্য এই পরিমাপটি হার্ডওয়্যারের ব্যয়ের সঙ্গে উৎপাদিত ব্যবহারযোগ্য আউটপুটের সম্পর্ক দেখায়।
খরচ ৪০% কমলে রেফারেন্স ব্যবস্থায় যে কাজের জন্য ১০০ ইউনিট খরচ হয়, সে কাজের খরচ হবে ৬০ ইউনিট। বাস্তবে কতটা সাশ্রয় হবে, তা নির্ভর করবে যন্ত্রপাতির দাম, বিদ্যুৎ ব্যবহার, সফটওয়্যার, কাজের ধরন এবং জিপিইউগুলো কতটা নিয়মিত ব্যস্ত থাকে তার ওপর।
প্রতিষ্ঠানটি তাদের পরবর্তী প্রজন্মের পিয়ার-টু-পিয়ার ইন্টারকানেক্ট ইঞ্জিনের একটি লক্ষ্যও জানিয়েছে: সংযুক্ত পরিসরের মধ্যে একবারের স্থানান্তরের সময় ৩ থেকে ৫ মাইক্রোসেকেন্ড থেকে কমিয়ে ১ মাইক্রোসেকেন্ডে আনা। বিভিন্ন জিপিইউতে মডেলের বিভিন্ন অংশ থাকলে এবং তাদের বারবার তথ্য বিনিময় করতে হলে দ্রুত যোগাযোগ কাজে আসে।
বিভিন্ন চিপের মধ্যে এআই কাজ ভাগ করে নেওয়া
Iluvatar CoreX-এর হেটেরোজেনিয়াস ডিপ্লয়মেন্ট পদ্ধতিতে ইনফারেন্সের বিভিন্ন অংশ বিভিন্ন ধরনের প্রসেসরে বরাদ্দ করা হয়। তাদের AFD বিভাজন পদ্ধতিতে Tiangai 300 পুরো প্রিফিল ধাপ এবং ডিকোডের সময় অ্যাটেনশন গণনা সামলায়। অংশীদার প্রতিষ্ঠানের XPU ফিড-ফরোয়ার্ড এক্সপার্ট নেটওয়ার্কগুলো চালায়।
XPU হলো অন্য ধরনের কম্পিউটিং অ্যাক্সিলারেটরের একটি ব্যাপকভাবে ব্যবহৃত নাম। মূল ধারণাটি হলো, প্রতিটি প্রসেসরকে তার জন্য সবচেয়ে উপযোগী কাজ দেওয়া, আর একটি সাধারণ শিডিউলার দিয়ে পুরো কাজ সমন্বয় করা। ভাষা মডেলের ভেতরে গাণিতিক প্রক্রিয়াকরণের আরেকটি বড় অংশ সম্পন্ন করে ফিড-ফরোয়ার্ড নেটওয়ার্ক।
সমন্বিত শিডিউলিংয়ের অধীনে ডিকোড ইনফারেন্সের ল্যাটেন্সি ৬০% কমেছে বলে জানিয়েছে প্রতিষ্ঠানটি। এটি H200-এর তুলনায় শিরোনামে উল্লেখ করা ৫% থ্রুপুট সুবিধার থেকে আলাদা ব্যবস্থা এবং এতে পারফরম্যান্সের ভিন্ন পরিমাপ ব্যবহার করা হয়েছে।
প্রতিষ্ঠানটির এআই ও অ্যাক্সেলারেটেড কম্পিউটিং বিভাগের প্রধান Shan Tianyi বলেছেন, ভবিষ্যতের এআই কম্পিউটিং ব্যবস্থা প্রতিটি কাজের জন্য এক ধরনের প্রসেসরের ওপর নির্ভর করার বদলে বিভিন্ন চিপ দক্ষভাবে সংগঠিত করার ওপর নির্ভর করবে। AFD প্রদর্শনীতে জিপিইউ ও অংশীদার প্রতিষ্ঠানের অ্যাক্সিলারেটর নিয়ে সেই কৌশলের একটি বাস্তব বিন্যাস দেখানো হয়েছে।
সফটওয়্যারের দাবি স্থাপনের সময় কমানোর লক্ষ্য
স্থাপন ও অপটিমাইজেশনের কিছু কাজ স্বয়ংক্রিয় করার জন্য Iluvatar CoreX এআই-নির্ভর একটি সফটওয়্যার স্ট্যাকও উপস্থাপন করেছে। প্রতিষ্ঠানটির দাবি, পরিবেশ তৈরির একটি কাজের সময় এক ঘণ্টা থেকে কমে ১০ মিনিট হয়েছে, আর হাতে করা কাজের সংখ্যা কয়েক ডজন থেকে কমে একটিতে নেমেছে।
একটি বড় মডেল অপটিমাইজেশনের কাজে সময় সাত দিন থেকে কমে দুই ঘণ্টার নিচে এসেছে, আর পারফরম্যান্স আগের মাত্রার প্রায় দ্বিগুণ হয়েছে বলে জানিয়েছে প্রতিষ্ঠানটি। এসব উদাহরণে হার্ডওয়্যারে মডেলগুলো দক্ষভাবে চালানোর জন্য প্রয়োজনীয় প্রকৌশল কাজের কথা বলা হয়েছে।
GPU গণনার রুটিন তৈরিতে ব্যবহৃত ভাষা FlyDSL-এর সঙ্গে গভীর সমন্বয়ের দাবিও করেছে প্রতিষ্ঠানটি। তাদের ভাষ্য অনুযায়ী, কম্পাইলের গতি ৯০%-এর বেশি বেড়েছে। আগে ১০ জনের এক দিন কাজ লাগত, এমন একটি কর্মপ্রবাহ এখন একজন ব্যক্তি কয়েক ঘণ্টার মধ্যে সম্পন্ন করতে পারেন বলেও জানিয়েছে তারা।
প্রসেসরের জন্য শুধু সক্ষম গাণিতিক হার্ডওয়্যার থাকলেই হয় না, তাই সফটওয়্যার সহায়তা গুরুত্বপূর্ণ। মডেল, গাণিতিক লাইব্রেরি ও ডিপ্লয়মেন্ট টুল একসঙ্গে কাজ করতে হয়। নতুন জিপিইউকে কার্যকর পরিষেবায় রূপান্তর করার আগে গ্রাহকদের কতটা প্রকৌশলগত কাজ করতে হতে পারে, সফটওয়্যার প্রদর্শনীগুলো সে বিষয়টি তুলে ধরে।
রোবটের ক্ষেত্রেও প্রস্তাব নিয়ে এসেছে TY1200
সাংহাইয়ের অনুষ্ঠানে Tongyang TY1200-ও প্রদর্শিত হয়। এটি এআই পিসি ও এমবডিড ইন্টেলিজেন্সের জন্য তৈরি আলাদা একটি প্রসেসর; এর মধ্যে বাস্তব জগতে অনুভব ও কাজ করতে পারে এমন রোবটও রয়েছে। এর ঘন গণনা সক্ষমতা ৩০০ TOPS, অর্থাৎ প্রতি সেকেন্ডে ৩০০ ট্রিলিয়ন অপারেশন বলে উল্লেখ করা হয়েছে। ঘন গণনায় শূন্য মান নিয়ে হিসাব বাদ দেওয়ার ওপর নির্ভর না করে কাজ গণনা করা হয়।
Qwen3.8-27B এবং Qwen3.6-35B-A3B নিয়ে পরীক্ষায় TY1200-এর পারফরম্যান্স Nvidia Thor T5000-এর ১.২ গুণে পৌঁছেছে বলে দাবি করেছে Iluvatar CoreX। বাস্তবভিত্তিক এআই পরিস্থিতিতে Cosmos-R2-2B ও Cosmos-R2-8B মডেলে যথাক্রমে Thor T5000-এর ১৫৮% ও ১৮০% পারফরম্যান্স পাওয়া গেছে বলে জানিয়েছে প্রতিষ্ঠানটি।
MuJoCo-Warp ব্যবহার করে GPU-ত্বরিত পদার্থবিজ্ঞানের সিমুলেশন চালাতে TY1200 সক্ষম বলেও জানিয়েছে প্রতিষ্ঠানটি। এতে রোবট উন্নয়ন ব্যবস্থা চলাচলের অনুকরণ করতে, নিয়ন্ত্রণ কৌশল প্রশিক্ষণ দিতে এবং স্থানীয়ভাবে কাজ পরীক্ষা করতে পারে। নিয়ন্ত্রণ কৌশল হলো চলাচলের সিদ্ধান্ত নিতে রোবটের ব্যবহৃত শেখা নির্দেশনাগুলোর সমষ্টি।
উল্লেখ করা প্রয়োগগুলোর মধ্যে রয়েছে চিকিৎসা নিতে আসা ব্যক্তিদের সহায়তাকারী রোবট, শিল্পক্ষেত্রের ভিশন এবং দর্শনার্থীদের পথনির্দেশ। পরবর্তী প্রজন্মের TY2000-এর লক্ষ্যমাত্রা গণনা সক্ষমতা 600T বলে উল্লেখ করা হয়েছে। এসব পণ্য বড় এআই সার্ভার থেকে ব্যবহারকারী ও যন্ত্রের কাছাকাছি কাজ করা সরঞ্জাম পর্যন্ত প্রতিষ্ঠানটির কৌশলকে বিস্তৃত করে।
মূল বিষয়গুলো
- ২০২৬ সালের ২৮ অক্টোবর সাংহাইয়ে Tiangai 300 হার্ডওয়্যার প্রদর্শন করেছে Iluvatar CoreX।
- প্রতি কার্ডে Nvidia H200-এর ১.০৫ গুণ সমতুল্য থ্রুপুটের দাবিতে Shanghai Electric Group-এর পরীক্ষার কথা উল্লেখ করেছে প্রতিষ্ঠানটি।
- আট-জিপিইউতে Qwen3-32B প্রশিক্ষণ প্রদর্শনীতে FP8 নির্ভুলতায় প্রতি কার্ডে H100-এর ১.৩৩ গুণ থ্রুপুট পাওয়া গেছে বলে জানানো হয়েছে।
- শিরোনামে উল্লেখ করা তৃতীয় পক্ষের বেঞ্চমার্কের বিস্তারিত পদ্ধতি প্রকাশ করা হয়নি।
- IXL144 র্যাকে রয়েছে ১৪৪টি জিপিইউ ও ১৮টি সিপিইউ; প্রতি ১০ লাখ কার্যকর টোকেনের খরচ ৪০% কমানোর দাবি করা হয়েছে।
- জিপিইউ ও XPU-র মধ্যে কাজ ভাগ করে নেওয়া পৃথক একটি ডিপ্লয়মেন্টে ডিকোড ল্যাটেন্সি ৬০% কমেছে বলে জানানো হয়েছে।
- অনুষ্ঠানে সফটওয়্যার স্বয়ংক্রিয়করণ এবং স্থানীয় এআই ও রোবটিকস সিমুলেশনে TY1200-এর প্রয়োগ নিয়েও আলোচনা হয়েছে।