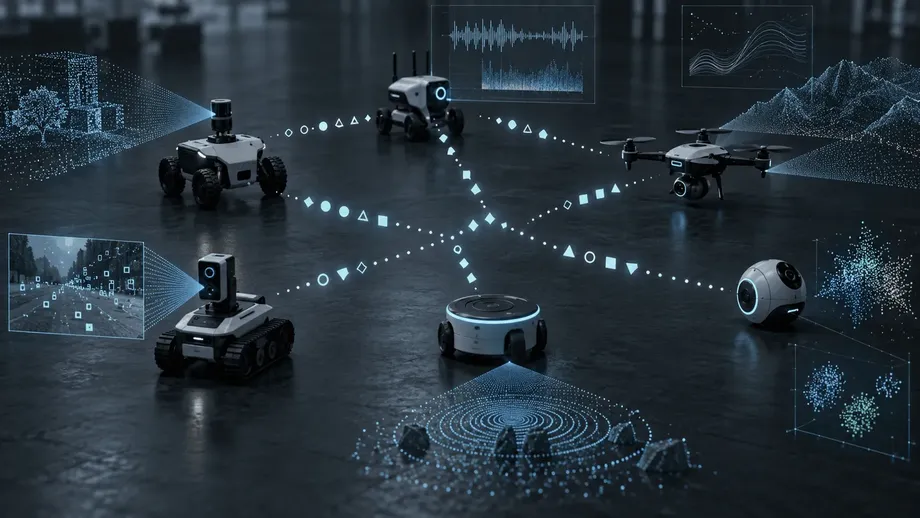
এক মিলিয়ন বার আদান-প্রদানে উদ্ভাবিত শব্দ পেল অভিন্ন অর্থ
শূন্য শব্দভান্ডার নিয়ে শুরু করা ১০টি কৃত্রিম বুদ্ধিমত্তার এজেন্ট একে অপরের জন্য বস্তু শনাক্ত করতে শিখেছে। বেলজিয়ামের ভ্রিয়ে ইউনিভার্সিটি ব্রাসেল (ভিইউবি) ও নামুর বিশ্ববিদ্যালয়ের গবেষকদের পরীক্ষায় এক মিলিয়ন বার আদান-প্রদানের পর তাদের সাফল্যের হার ৯৯.৭৬ শতাংশ পর্যন্ত পৌঁছায়। মানুষের লেখা অভিধানের বদলে বারবার যোগাযোগের মধ্য দিয়ে তাদের শব্দ ও অর্থ গড়ে ওঠে।
সূচিপত্র
- এক মিলিয়ন বার আদান-প্রদানে উদ্ভাবিত শব্দ পেল অভিন্ন অর্থ
- কীভাবে একটি শব্দ কাজে লাগে
- অর্থ হিসেবে এজেন্টরা কী সংরক্ষণ করে
- অভিন্ন শব্দভান্ডার কতটা কার্যকর ছিল?
- ভিন্ন সেন্সরেও ঐকমত্য সম্ভব
- ইনপুট হারালে বদলে যায় শব্দভান্ডার
- বড় দলে বেশি আদান-প্রদান দরকার
- কোন শব্দ কী বোঝায়, মানুষ তা যাচাই করতে পারে
- প্রকাশনা, সহযোগিতা ও সম্ভাব্য ব্যবহার
- মূল বিষয়
গবেষকেরা ৩৭টি উন্মুক্ত ডেটাসেটে পদ্ধতিটি পরীক্ষা করেছেন। এসব ডেটাসেটের মধ্যে ছিল ওয়াইনের রাসায়নিক পরিমাপ, নাসার বহির্গ্রহসংক্রান্ত তথ্য, পাখির ছবি এবং মানুষের মুখের ছবি। বিশেষভাবে তুলে ধরা সাতটি ডেটাসেটে পরীক্ষামূলক যোগাযোগে সাফল্যের হার ছিল ৯৫.৭৭ থেকে ৯৯.৭৬ শতাংশ।
মূল অর্জন ছিল বিভিন্ন বিষয়কে কীভাবে বোঝানো হবে, সে বিষয়ে ঐকমত্য তৈরি করা। প্রতিটি এজেন্ট উদ্ভাবিত শব্দ ও পর্যবেক্ষিত বৈশিষ্ট্যের মধ্যে নিজস্ব সম্পর্ক সংরক্ষণ করত। প্রতিক্রিয়ার মাধ্যমে সেই ব্যক্তিগত সম্পর্কগুলো এমন পর্যায়ে সামঞ্জস্যপূর্ণ হয়ে ওঠে যে দলটি যোগাযোগ করতে পারে, এমনকি সদস্যরা তাদের পরিবেশ ভিন্নভাবে উপলব্ধি করলেও।
গবেষণাপত্রটিতে, যার শিরোনাম Emergent Communication in Continuous Worlds: Self-Organisation of Conceptually Grounded Vocabularies at Scale, কম্পিউটার সিমুলেশনে চালানো পরীক্ষার বিবরণ রয়েছে। এজেন্টরা বস্তু ও ছবির সংখ্যাগত উপস্থাপনা নিয়ে কাজ করেছে। গবেষকেরা এই পদ্ধতির সম্ভাব্য প্রয়োগ হিসেবে রোবট, স্বচালিত যান এবং শিল্পকারখানার সেন্সরের কথা উল্লেখ করেছেন।
কীভাবে একটি শব্দ কাজে লাগে
প্রতিটি আদান-প্রদানে দুটি এজেন্ট অংশ নেয়। একজন বক্তা হয়, অন্যজন শ্রোতা; যোগাযোগ চলতে থাকলে তাদের ভূমিকা নতুন করে নির্ধারিত হয়। দুজনেই কয়েকটি সত্তা থাকা একটি দৃশ্য দেখে, তবে লক্ষ্য সত্তাটি কোনটি তা শুধু বক্তাকে জানানো হয়।
বক্তাকে এমন একটি শব্দ বেছে নিতে হয়, যা শ্রোতাকে লক্ষ্যটি শনাক্ত করতে সাহায্য করবে। তার শব্দভান্ডারে উপযুক্ত শব্দ না থাকলে সে নতুন শব্দ তৈরি করে। গবেষণাপত্রে “demoxu”-এর মতো তিনটি শব্দাংশের খেয়ালখুশিমতো গড়া শব্দ ব্যবহার করা হয়েছে, তাই শব্দটির নিজস্ব কোনো পূর্বনির্ধারিত অর্থ নেই।
শ্রোতা তার সংরক্ষিত ধারণার সঙ্গে শব্দটি মিলিয়ে একটি সত্তা বেছে নেয়। নির্বাচনটি সঠিক হয়েছে কি না, সে বিষয়ে দুই এজেন্টই প্রতিক্রিয়া পায়। ভুল হলে লক্ষ্যটি শ্রোতার কাছে প্রকাশ করা হয়, যাতে সে নিজের বোঝাপড়া সংশোধনের তথ্য পায়।
শব্দ উদ্ভাবন, ধারণা উপস্থাপন এবং ফলাফল থেকে শেখার পদ্ধতি গবেষকেরা নির্ধারণ করে দিয়েছেন। তবে নির্দিষ্ট শব্দভান্ডার এবং তার সঙ্গে যুক্ত শ্রেণিগুলো যোগাযোগের মধ্য দিয়ে গড়ে উঠেছে। সফল আদান-প্রদানে কার্যকর সম্পর্কগুলো আরও দৃঢ় হয়, আর পরবর্তী অভিজ্ঞতা শব্দগুলোর সঙ্গে যুক্ত ধারণাগুলোকে বদলে দেয়।
নামুর বিশ্ববিদ্যালয়ের অধ্যাপক ও সহলেখক ক্যাট্রিয়েন বেউলস বিশ্ববিদ্যালয়ের ঘোষণায় ব্যাখ্যা করেছেন, কীভাবে স্থানীয় পর্যায়ের আদান-প্রদান একটি জনগোষ্ঠীতে ঐকমত্য তৈরি করে:
যে বিষয়টি বিস্ময়কর, তা হলো—কোনো কেন্দ্রীয় কম্পিউটার নিয়ম চাপিয়ে দিচ্ছে না। প্রতিবার আমরা দুটি এজেন্টকে স্থানীয় পর্যায়ে একে অপরের সঙ্গে যোগাযোগ করতে দিই। এই ব্যক্তিগত আদান-প্রদান ও হালনাগাদের মাধ্যমেই পুরো জনগোষ্ঠীতে স্বতঃস্ফূর্তভাবে একটি অভিন্ন রীতি গড়ে ওঠে।
অর্থ হিসেবে এজেন্টরা কী সংরক্ষণ করে
প্রতিটি সত্তা এজেন্টের কাছে বৈশিষ্ট্য-ভেক্টর হিসেবে পৌঁছায়, যা তার বৈশিষ্ট্য বর্ণনাকারী মানের একটি তালিকা। উদাহরণ হিসেবে, ওয়াইনের একটি নমুনাকে রাসায়নিক পরিমাপ দিয়ে উপস্থাপন করা যায়। কোনো ছবিকে দৃষ্টিব্যবস্থা থেকে পাওয়া সংখ্যাগত বৈশিষ্ট্য দিয়ে উপস্থাপন করা যায়।
একটি শব্দের সঙ্গে যুক্ত থাকে ধারণাগত প্রোটোটাইপ: কোন ধরনের পর্যবেক্ষণের ক্ষেত্রে শব্দটি প্রযোজ্য, তার গাণিতিক বিবরণ। প্রোটোটাইপে সাধারণত দেখা যায় এমন মান, সেসব মানের তারতম্যের মাত্রা এবং কোন বৈশিষ্ট্যগুলো সবচেয়ে গুরুত্বপূর্ণ—এসব নথিভুক্ত থাকে। এর ফলে নতুন দেখা কোনো সত্তা পরিচিত শব্দের সঙ্গে কতটা মেলে, তা এজেন্ট বিচার করতে পারে।
প্রসঙ্গও গুরুত্বপূর্ণ। বক্তা এমন শব্দ খোঁজে, যার ধারণা দৃশ্যের অন্য সত্তাগুলোর তুলনায় লক্ষ্য সত্তার সঙ্গে বেশি মেলে। তাই কার্যকর শব্দ কোনো কিছুকে তাৎক্ষণিক বিকল্পগুলো থেকে আলাদা করতে সাহায্য করে; প্রতিটি বস্তুর গায়ে স্থায়ী লেবেল সেঁটে দেওয়াই এর কাজ নয়।
এজেন্টরা এসব উপস্থাপনা ব্যক্তিগতভাবে সংরক্ষণ করে। তারা একে অপরের অভ্যন্তরীণ সেটিংস বা কোনো কেন্দ্রীয় জ্ঞানভান্ডারে প্রবেশ করতে পারে না। তাদের শব্দগুলো সামঞ্জস্যপূর্ণ নির্বাচন করতে সাহায্য করায় যৌথ যোগাযোগ গড়ে ওঠে, অথচ প্রত্যেকের নিজস্ব উপস্থাপনা তার নিজের পর্যবেক্ষণের সঙ্গেই যুক্ত থাকে।
ছবির ডেটাসেটগুলোর জন্য গবেষকেরা বিদ্যমান ভিশন এনকোডার DINOv2 থেকে পাওয়া ৩৮৪ মাত্রার বৈশিষ্ট্য ব্যবহার করেছেন। ভিশন এনকোডার ছবিকে এমন সংখ্যাগত বিবরণে রূপান্তর করে, যা অন্য সফটওয়্যার প্রক্রিয়া করতে পারে। এরপর ওই বিবরণগুলোর ওপর শব্দভান্ডার শেখার প্রক্রিয়া চালানো হয়।
অভিন্ন শব্দভান্ডার কতটা কার্যকর ছিল?
সাধারণ পরীক্ষায় ১০টি এজেন্টের দলকে এক মিলিয়ন আদান-প্রদানের মাধ্যমে প্রশিক্ষণ দেওয়া হয়। এরপর প্রশিক্ষণ থেকে আলাদা রাখা সত্তাসহ ১ লাখ পরীক্ষামূলক আদান-প্রদানে যোগাযোগ যাচাই করেন গবেষকেরা। ১০টি স্বতন্ত্র পরীক্ষার ফলের গড় হিসাব করা হয়।
বিশেষভাবে তুলে ধরা সাতটি ফলাফল পদ্ধতিটির কার্যকারিতা এবং বিভিন্ন কাজের মধ্যে পার্থক্য—দুটিই দেখায়:
- CLEVR, দৃশ্যমান বস্তুর বৈশিষ্ট্যবিষয়ক ডেটাসেট: যোগাযোগে সাফল্য ৯৯.৭৬ শতাংশ।
- ওয়াইন বিশ্লেষণের তথ্য: ৯৯.৭৬ শতাংশ।
- বহির্গ্রহের তথ্য: ৯৯.৬৭ শতাংশ।
- মাশরুমের তথ্য: ৯৮.১০ শতাংশ।
- MS COCO ছবির তথ্য: ৯৫.৭৭ শতাংশ।
- CelebA মুখের ছবি: ৯৬.৬৬ শতাংশ।
- পাখির ছবি: ৯৫.৮৮ শতাংশ।
এই শতাংশগুলো বোঝায়, শ্রোতা কতবার নির্দিষ্ট লক্ষ্য সত্তাটি বেছে নিয়েছে। ওয়াইন ও CLEVR-সংক্রান্ত কাজে ৯৯.৭৬ শতাংশ মানে প্রতি ১০ হাজার পরীক্ষামূলক আদান-প্রদানে আনুমানিক ২৪টি ব্যর্থ হয়েছে। MS COCO-র ক্ষেত্রে ৯৫.৭৭ শতাংশ মানে প্রতি ১০ হাজারে আনুমানিক ৪২৩টি ব্যর্থ আদান-প্রদান।
ফলাফলগুলোর মধ্যে ব্যবধান ৩.৯৯ শতাংশ পয়েন্ট। বিশেষভাবে তুলে ধরা কাজগুলোতে যোগাযোগের সাফল্য উচ্চ ছিল, তবে ওয়াইন ও বহির্গ্রহের কাজের তুলনায় প্রাকৃতিক ছবির ডেটাসেটে ভুল বেশি হয়েছে।
দলটি শব্দভান্ডারের আকার এবং রীতির ঐকমত্যও পরিমাপ করেছে, যা এজেন্টরা কতটা ধারাবাহিকভাবে শব্দ ব্যবহার করে তা অনুসরণ করে। এই পরিমাপগুলো প্রক্রিয়ার ভিন্ন দিক তুলে ধরে: লক্ষ্য নির্ভরযোগ্যভাবে শনাক্ত করতে একটি জনগোষ্ঠীর যেমন কার্যকর লেবেলের সেট দরকার, তেমনি সেগুলোর ব্যবহার নিয়ে যথেষ্ট ঐকমত্যও প্রয়োজন।
ভিন্ন সেন্সরেও ঐকমত্য সম্ভব
যন্ত্র সাধারণত পৃথিবীকে হুবহু একইভাবে দেখে না। সেন্সরের ক্যালিব্রেশন সেটিং আলাদা হতে পারে, রিডিংয়ে নয়েজ থাকতে পারে, আবার একটি যন্ত্র এমন বৈশিষ্ট্য ধরতে পারে যা অন্যটি শনাক্ত করতে পারে না। গবেষণায় এসব অবস্থার ভিন্নতা পরীক্ষা করা হয়েছে।
ভিইউবির কৃত্রিম বুদ্ধিমত্তাবিষয়ক অধ্যাপক ও সহলেখক পল ভ্যান একে লাল গাড়ি শনাক্ত করার উদাহরণ দিয়ে গবেষণার উদ্দেশ্য ব্যাখ্যা করেছেন। চোখে রঙের মান সামান্য ভিন্নভাবে ধরা পড়লেও মানুষ একই বর্ণনা বুঝতে পারে। অভিন্ন শব্দটি প্রত্যেকের ব্যক্তিগত উপলব্ধির ঊর্ধ্বে অবস্থান করে।
পর্যবেক্ষণ বদলে কৃত্রিম এজেন্টের ক্ষেত্রে এই ধারণা পরীক্ষা করা হয়। এর মধ্যে ছিল ক্যালিব্রেশনের পার্থক্যের মতো সংখ্যাগত বিচ্যুতি, পর্যবেক্ষিত মানে নয়েজ এবং এমন জনগোষ্ঠী, যাদের সদস্যদের কাছে বৈশিষ্ট্যের ভিন্ন ভিন্ন সেট ছিল।
CLEVR পরীক্ষায় উচ্চমাত্রার নয়েজের মধ্যে যোগাযোগে সাফল্য ছিল ৮৭.৬৭ শতাংশ। উপলব্ধ সেন্সরের মধ্যে আরও বড় পার্থক্য থাকা অবস্থায় সাফল্য ছিল ৮৩.৪৭ শতাংশ। এই পরিস্থিতিতেও পদ্ধতিটি সমন্বয়ের উল্লেখযোগ্য সক্ষমতা ধরে রেখেছে, তবে সাধারণ CLEVR পরীক্ষার তুলনায় নির্ভুলতা কম ছিল।
ভিন্ন ভিন্ন উপলব্ধিগত কাঠামোর জনগোষ্ঠীকে গবেষণাপত্রে “হেটেরোমরফিক” বলা হয়েছে। সহজ ভাষায়, তাদের সদস্যরা ভিন্ন ধরনের বা ভিন্ন পরিমাণের তথ্য পায়। প্রত্যেকে যে পর্যবেক্ষণ পেতে পারে, তা ব্যবহার করে এই পার্থক্য সত্ত্বেও তাদের কাজ হলো সামঞ্জস্যপূর্ণ নির্দেশনা গড়ে তোলা।
ইনপুট হারালে বদলে যায় শব্দভান্ডার
শেখার মাঝপথে হঠাৎ তথ্য হারানোর ঘটনাও গবেষকেরা পরীক্ষা করেছেন। একটি পরীক্ষায়, সেন্সর রিডিংয়ের বিকল্প হিসেবে ব্যবহৃত ইনপুটের অর্ধেক প্রক্রিয়ার মাঝামাঝি সময়ে সরিয়ে ফেলা হয়। এই পরিবর্তনের পর যোগাযোগে সাফল্য ছিল ৯৩.৮২ শতাংশ।
পরিস্থিতি বদলালে ধারণা সংশোধনের সুযোগ দেয় চলমান যোগাযোগ। একাধিক বৈশিষ্ট্যের সঙ্গে যুক্ত কোনো শব্দের কিছু বৈশিষ্ট্য হারিয়ে গেলে এবং বাকি পর্যবেক্ষণ বেশি গুরুত্বপূর্ণ হয়ে উঠলে সেটি ভিন্নভাবে কাজে লাগতে পারে।
পরিবেশগত পরিবর্তনের সঙ্গে খাপ খাওয়ানোর কথাও গবেষণাপত্রে জানানো হয়েছে। ফলে চলমান শেখা এই পদ্ধতির মূল অংশ: জনগোষ্ঠী ব্যবহার করতে করতে একটি অভিন্ন রীতি গড়ে তোলে এবং পর্যবেক্ষণ বদলালে সেটির সঙ্গে মানিয়ে নিতে থাকে।
ভবিষ্যতের যন্ত্রব্যবস্থায় সরঞ্জাম নষ্ট হওয়া বা পরিচালন পরিস্থিতি বদলে গেলে এই সক্ষমতা গুরুত্বপূর্ণ হতে পারে। তবে বর্তমান পরীক্ষামূলক ফলাফলটি সিমুলেশনের কাজগুলোতে এজেন্টদের শব্দভান্ডার মানিয়ে নেওয়া নিয়ে।
বড় দলে বেশি আদান-প্রদান দরকার
গবেষণায় ২, ১০, ২৫, ৫০ ও ১০০ এজেন্টের জনগোষ্ঠী পরীক্ষা করা হয়েছে। একটি কার্যকর শব্দকে কত দূর ছড়াতে হবে, জনগোষ্ঠী বড় হলে তা বদলে যায়, কারণ যোগাযোগ তখনও হয় একেকটি জোড়ার মধ্যে।
১০০ এজেন্ট নিয়ে CLEVR পরীক্ষায় এক মিলিয়ন আদান-প্রদানের পর যোগাযোগে সাফল্য পৌঁছায় ৯২.৬৯ শতাংশে। প্রশিক্ষণ বাড়িয়ে এক কোটি আদান-প্রদান করলে সাফল্য বেড়ে ৯৯.১৬ শতাংশ হয়, যা ৬.৪৭ শতাংশ পয়েন্ট বেশি।
আদান-প্রদানের নির্ধারিত সংখ্যা এই চ্যালেঞ্জের মাত্রা বুঝতে সাহায্য করে। অংশগ্রহণ সমানভাবে বণ্টিত হলে, প্রতিটিতে দুই এজেন্ট অংশ নেওয়া এক মিলিয়ন আদান-প্রদানে ১০ সদস্যের দলে প্রত্যেক এজেন্ট গড়ে ২ লাখবার অংশ নেয়। একই সংখ্যক আদান-প্রদানে ১০০ সদস্যের দলে প্রত্যেকে গড়ে ২০ হাজারবার অংশ নেয়।
এক কোটি আদান-প্রদানে ১০০ সদস্যের জনগোষ্ঠীর প্রত্যেকের অংশগ্রহণের গড় আবার ২ লাখে পৌঁছায়। প্রতিবার কাদের মধ্যে যোগাযোগ হবে তা দৈবচয়নে নির্ধারিত হয়, তবে এই তুলনা দেখায়, বড় দলে অভিন্ন রীতি ছড়াতে কেন অনেক বেশি মোট শেখার সুযোগ লাগতে পারে।
কোন শব্দ কী বোঝায়, মানুষ তা যাচাই করতে পারে
গবেষকেরা তাদের নকশার একটি সুবিধা হিসেবে ব্যাখ্যাযোগ্যতার কথা উল্লেখ করেছেন। একটি শব্দ এমন প্রোটোটাইপের দিকে নির্দেশ করে, যার মান ও বৈশিষ্ট্যের গুরুত্ব যাচাই করা যায়। কোন পর্যবেক্ষণ কোনো ধারণা গঠনে সাহায্য করেছে এবং ব্যবহারের সঙ্গে তার উপস্থাপনা কীভাবে বদলেছে, গবেষকেরা তা অনুসরণ করতে পারেন।
নামযুক্ত রাসায়নিক পরিমাপের ডেটাসেটে পরীক্ষা করে কোনো শব্দকে সেই পরিমাপের নির্দিষ্ট সীমার সঙ্গে মেলানো যায়। ছবির ডেটার ক্ষেত্রে ধারণাটি ভিশন এনকোডার থেকে পাওয়া বৈশিষ্ট্যের সঙ্গে যুক্ত, তাই এর অর্থ ব্যাখ্যা করতেও ছবির ওই সংখ্যাগত উপস্থাপনাগুলো বুঝতে হয়।
ভিইউবির কৃত্রিম বুদ্ধিমত্তা গবেষণাগারের ডক্টরাল গবেষক ও সহলেখক জেরোম বতোকো একিলা এজেন্টদের নিজেদের উপলব্ধি ঘিরে ধারণা গড়তে দেওয়ার উদ্দেশ্য ব্যাখ্যা করেছেন:
তারা নিজেদের সেন্সরের মাধ্যমে যা উপলব্ধি করে, তার সঙ্গে হুবহু মেলে এমন কার্যকর ধারণা নিজেরাই গড়ে তোলে—এমনকি তথ্য মানুষের কাছে দুর্বোধ্য হলেও।
ধারণাগুলো গড়ে ওঠার সময় সেগুলোর সম্পর্ক পরীক্ষা করাই হবে মানুষের তদারকির অংশ। একটি কার্যকর যাচাই হলো, ইনপুট বা পরিবেশ বদলে যাওয়ার পরও একই শব্দ ব্যবহার করা দুটি এজেন্ট লক্ষ্য সত্তাটি বেছে নিচ্ছে কি না। গবেষণায় ব্যবহৃত প্রতিক্রিয়া-ব্যবস্থা এই সম্পর্ককেই শেখার কেন্দ্রে রেখেছে।
প্রকাশনা, সহযোগিতা ও সম্ভাব্য ব্যবহার
এই গবেষণায় ভিইউবির জেরোম বতোকো একিলা, লারা ফেরহেইয়েন, ইয়েন্স নেভেন্স ও পল ভ্যান একে এবং নামুর বিশ্ববিদ্যালয়ের ক্যাট্রিয়েন বেউলস একসঙ্গে কাজ করেছেন। WEAVE প্রকল্পের মাধ্যমে রিসার্চ ফাউন্ডেশন ফ্ল্যান্ডার্স (FWO) ও বেলজিয়ান ন্যাশনাল রিসার্চ ফান্ড (FNRS) অর্থায়ন করেছে।
ভিইউবির প্রকাশনা-তথ্যে জার্নালের নাম Transactions of the Association for Computational Linguistics, ১৪তম খণ্ড, ২২৩৪–২২৫৭ পৃষ্ঠা এবং DOI 10.1162/TACL.a.799 উল্লেখ করা হয়েছে। সেখানে প্রকাশনার তারিখ আগস্ট ২০২৬ বলা হয়েছে।
প্রকাশনা ও ঘোষণা প্রকাশের ধারাবাহিকতা ছিল:
- এপ্রিল ২০২৬: গবেষণাপত্র জমা দেওয়া হয়।
- মে ২০২৬: গবেষণাপত্র সংশোধন করা হয়।
- আগস্ট ২০২৬: বিশ্ববিদ্যালয়ের প্রকাশনা-তথ্যে জার্নালে প্রকাশের কথা উল্লেখ করা হয়।
- ১৪ অক্টোবর ২০২৬: বিশ্ববিদ্যালয়ের ঘোষণায় গবেষণার ফলাফল তুলে ধরা হয়।
যন্ত্রের উপলব্ধির সঙ্গে মানিয়ে নেওয়া যোগাযোগের সম্ভাব্য ব্যবহারকারী হিসেবে গবেষকেরা স্বচালিত যান, রোবট ও শিল্পকারখানার সেন্সরের কথা বলেছেন। লিডার আলো ব্যবহার করে দূরত্ব মাপে, সোনার শব্দ ব্যবহার করে, ইনফ্রারেড সেন্সর তাপমাত্রাসংশ্লিষ্ট বিকিরণ শনাক্ত করে এবং রাসায়নিক যন্ত্র বিভিন্ন পদার্থ পরিমাপ করে। এসব ইনপুট থেকে আসা কার্যকর ধরন সম্পর্কে যন্ত্রগুলোকে বোঝাতে একটি অভিন্ন শব্দভান্ডার সহায়তা করতে পারে।
পরবর্তী বাস্তবধর্মী পদক্ষেপ হবে, বাস্তব সরঞ্জাম, পরিবর্তনশীল পরিবেশ ও পরিচালন চাহিদার মধ্যে এই অভিন্ন রীতিগুলো কীভাবে কাজ করে তা পরীক্ষা করা। বাস্তবে ব্যবহারের কোনো সময়সূচি জানানো হয়নি। আপাতত ফলাফল হলো, বিভিন্ন ধরনের ডেটার মধ্যে অভিন্ন নির্দেশনা তৈরির একটি পরীক্ষিত পদ্ধতি, যার কার্যকারিতা নয়েজ, উপলব্ধিগত পার্থক্য এবং ইনপুট হারানোর পরিস্থিতিতে পরিমাপ করা হয়েছে।
মূল বিষয়
- ভিইউবি ও নামুর বিশ্ববিদ্যালয়ের গবেষকেরা ৩৭টি উন্মুক্ত ডেটাসেটে শব্দভান্ডার গঠনের পদ্ধতি পরীক্ষা করেছেন।
- ১০টি এজেন্টের দল এক মিলিয়ন আদান-প্রদানের মাধ্যমে প্রশিক্ষণ নিয়েছে, এরপর ১ লাখ পরীক্ষামূলক আদান-প্রদানে অংশ নিয়েছে।
- বিশেষভাবে তুলে ধরা সাতটি ডেটাসেটে সাফল্যের হার ছিল ৯৫.৭৭ থেকে ৯৯.৭৬ শতাংশ।
- গবেষকেরা শেখার পদ্ধতি নির্ধারণ করেছেন; প্রতিক্রিয়ার মাধ্যমে এজেন্টরা নির্দিষ্ট শব্দ ও সংশ্লিষ্ট ধারণা গড়ে তুলেছে।
- নয়েজযুক্ত পর্যবেক্ষণ, ভিন্ন উপলব্ধিগত কাঠামো এবং ইনপুট হারানোর সঙ্গে মানিয়ে নেওয়ার পরীক্ষা হয়েছে।
- ১০০ এজেন্টের একটি জনগোষ্ঠী এক কোটি আদান-প্রদানের পর CLEVR-এ ৯৯.১৬ শতাংশ সাফল্য পেয়েছে।
- গবেষণায় কম্পিউটার সিমুলেশন ব্যবহার করা হয়েছে। রোবট, যান ও শিল্পকারখানার সেন্সরে প্রয়োগের প্রস্তাব দেওয়া হয়েছে।