RNA-র অক্ষর ও তাদের সংযোগ শেখে যে মডেল
চীনের ইউনিভার্সিটি অব সায়েন্স অ্যান্ড টেকনোলজির গবেষকেরা structRFM প্রকাশ করেছেন। এটি একটি উন্মুক্ত RNA ফাউন্ডেশন মডেল, যা ২ কোটি ১০ লাখ RNA সিকোয়েন্স ও গণনাভিত্তিকভাবে নির্ধারিত কাঠামোর জোড়া দিয়ে প্রশিক্ষিত। প্রকাশনার সঙ্গে রয়েছে জোড়াভিত্তিক প্রশিক্ষণ-তথ্য, মডেলের ওজন এবং সোর্স কোড, যাতে অন্য গবেষণাগারগুলো কাজটি পুনরুৎপাদনের উপকরণ পায় এবং নিজেদের প্রয়োজনে সিস্টেমটি মানিয়ে নিতে পারে।
সূচিপত্র
- RNA-র অক্ষর ও তাদের সংযোগ শেখে যে মডেল
- সিকোয়েন্সের মতো ভাঁজও কেন গুরুত্বপূর্ণ
- ২ কোটি ১০ লাখ প্রশিক্ষণ জোড়া যেভাবে তৈরি
- আড়াল করা তথ্য দিয়ে মডেলকে শেখানো
- কাঠামো পরীক্ষায় কী দেখা গেছে
- RNA প্রক্রিয়াকরণ থেকে কার্যভিত্তিক শ্রেণিবিন্যাস
- উন্মুক্ত প্রকাশনা গবেষকদের কী দিচ্ছে
- গবেষক দল ও প্রকাশনার সময়রেখা
- RNA গবেষণায় ফলাফলগুলোর প্রভাব
- মূল বিষয়গুলো
৪ নভেম্বর ২০২৬-এ Nature-এ প্রকাশিত গবেষণাপত্রে এমন একটি মডেলের বর্ণনা দেওয়া হয়েছে, যা RNA-র আণবিক গঠন-এককগুলোর বিন্যাস এবং অণুগুলোকে ভাঁজ হতে সাহায্য করা সংযোগ—দুটিই শেখে। ত্রিমাত্রিক কাঠামো পূর্বাভাসের জন্য এর অভিযোজিত সংস্করণ Zfold তৈরি করা হয়েছে। CASP15-natural, CASP16 এবং RNA-Puzzles মূল্যায়নে এর কার্যকারিতা AlphaFold3-এর সঙ্গে তুলনীয় বলে লেখকেরা উল্লেখ করেছেন।
এই মডেলের ব্যবহারিক সুবিধা হলো, প্রশিক্ষণের পর structRFM-কে ইনপুট হিসেবে শুধু একটি RNA সিকোয়েন্স দিলেই চলে। এটি এমন তথ্য তৈরি করে, যা গবেষকেরা আণবিক কাঠামো পূর্বাভাস, RNA প্রক্রিয়াকরণে জড়িত স্থান শনাক্ত এবং কাজ অনুযায়ী RNA অণুর শ্রেণিবিন্যাসসহ বিভিন্ন কাজে ব্যবহার করতে পারেন।
Nature-এ প্রকাশিত structRFM গবেষণাপত্রে কাজটিকে বিভিন্ন পূর্বাভাসের কাজে কাঠামোগত জ্ঞান ব্যবহারযোগ্য করে তোলার একটি উপায় হিসেবে তুলে ধরা হয়েছে। পেং শিয়ং ও এস. কেভিন ঝৌ সংশ্লিষ্ট লেখক, আর হেচিন ঝু প্রথম লেখক।
সিকোয়েন্সের মতো ভাঁজও কেন গুরুত্বপূর্ণ
প্রোটিন উৎপাদন, জিন নিয়ন্ত্রণ এবং জিনগত বার্তা প্রক্রিয়াকরণে RNA অংশ নেয়। এর সিকোয়েন্স হলো নিউক্লিওটাইডের বিন্যাস—আণবিক একক, যেগুলো সাধারণত A, U, C ও G অক্ষর দিয়ে প্রকাশ করা হয়। এই বিন্যাসে তথ্য থাকে, আর অণুটি যেভাবে ভাঁজ হয় তা এর কাজ নির্ধারণে ভূমিকা রাখে।
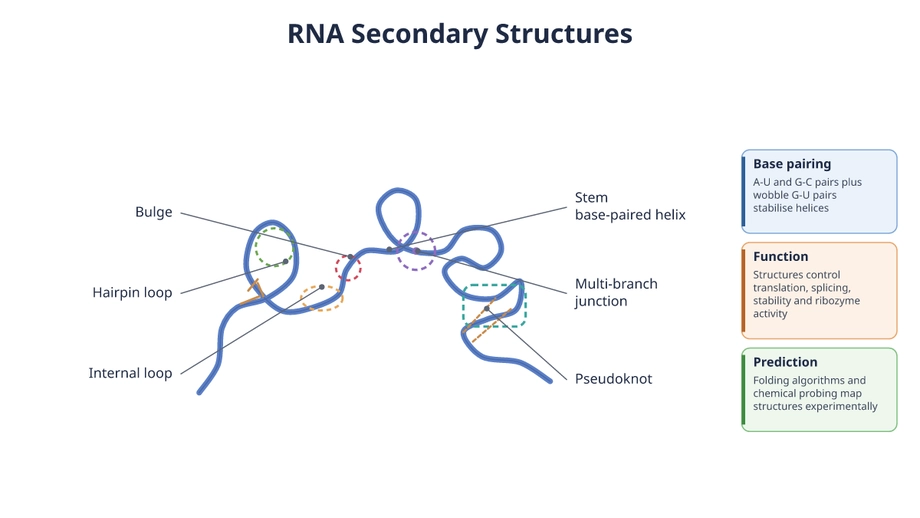
RNA-র একটি সূত্রের অংশ একই সূত্রের অন্য অংশের সঙ্গে জোড়া বাঁধতে পারে। এসব সংযোগ তৈরি করে সেকেন্ডারি কাঠামো, যেখানে জোড়া বাঁধা অঞ্চল, স্টেম ও লুপের বিন্যাস থাকে। এরপর অণুটি ভাঁজ হয়ে ত্রিমাত্রিক আকৃতি নেয়, যাকে টারশিয়ারি কাঠামো বলা হয়। এই কাঠামো অণুটির কার্যকলাপ এবং অন্য অণুর সঙ্গে এর মিথস্ক্রিয়াকে প্রভাবিত করে।
অনেক RNA ভাষা মডেল বড় সিকোয়েন্স-সংকলন থেকে বিন্যাস শেখে, যেমন ভাষা মডেল শব্দের পারস্পরিক সম্পর্ক শেখে। structRFM প্রশিক্ষণের সময় কোন নিউক্লিওটাইডগুলো পরস্পরের সঙ্গে জোড়া বাঁধে, সেই তথ্যও যোগ করে। ফলে সিকোয়েন্সে অনেক দূরে থাকা অবস্থানগুলোর সংযোগ শেখার সুযোগ পায় মডেলটি।
গবেষকেরা ফাউন্ডেশন মডেলের নমনীয়তা বজায় রাখতে চেয়েছেন: এমন একটি বিস্তৃতভাবে প্রশিক্ষিত সিস্টেম, যার শেখা বৈশিষ্ট্য বিভিন্ন উদ্দেশ্যে মানিয়ে নেওয়া যায়। তাঁদের লক্ষ্য ছিল, শুধু একটি কাঠামোগত কাজের জন্য কার্যকর সিস্টেম প্রশিক্ষণ না দিয়ে, বিভিন্ন কাজে কাজে লাগানো যায় এমন অভিন্ন ভিত্তিতে ভাঁজ-সংক্রান্ত তথ্য যুক্ত করা।
২ কোটি ১০ লাখ প্রশিক্ষণ জোড়া যেভাবে তৈরি
দলটি প্রায় ২ কোটি ১০ লাখ RNA সিকোয়েন্স ও সেকেন্ডারি কাঠামোর জোড়া নিয়ে একটি ডেটাসেট তৈরি করেছে। কাঠামোগত টীকা গণনাভিত্তিকভাবে তৈরি করা হয়েছে। ফলে গবেষকেরা শুধু পরীক্ষাগারে নির্ণীত কাঠামো নিয়ে গঠিত সংকলনের তুলনায় অনেক বড় পরিসরে মডেল প্রশিক্ষণ দিতে পেরেছেন।
কম্পিউটারের পূর্বাভাসে ভুল থাকতে পারে এবং তা পূর্বাভাস-পদ্ধতির শক্তি ও দুর্বলতার প্রতিফলন ঘটাতে পারে। কোনো একটি পূর্বাভাসদাতার ওপর নির্ভরতা কমাতে গবেষকেরা MUSES নামে একাধিক উৎসনির্ভর সেকেন্ডারি-কাঠামো এনসেম্বল চালু করেছেন। এনসেম্বল কোনো একটি উৎসের ওপর পুরোপুরি নির্ভর না করে কয়েকটি পূর্বাভাস-উৎসের তথ্য একত্র করে।
পূর্বাভাস করা কাঠামো দিয়ে মডেলকে শেখানোর ক্ষেত্রে একটি বড় সমস্যা হলো, প্রশিক্ষণ-টীকায় একই ধরনের ভুল বারবার থাকলে তা মডেল কী শেখে, সেটিকে প্রভাবিত করতে পারে। বেস-পেয়ারিং সম্পর্কে কার্যকর তথ্য বজায় রেখে পূর্বাভাসদাতার পক্ষপাত কমানোর উদ্দেশ্যে কাঠামোগত পূর্বাভাসগুলো একত্র করা হয়েছে।
গবেষণার প্রশিক্ষণ ও মূল্যায়নের উপকরণে RNAcentral, Rfam এবং Protein Data Bank-সহ প্রতিষ্ঠিত জৈবিক ডেটাসেট ব্যবহার করা হয়েছে। ডেটা-সংক্রান্ত বিবৃতিতে ব্যবহৃত সংস্করণগুলোর উল্লেখ রয়েছে—এর মধ্যে RNAcentral-এর 24.0 সংস্করণ এবং Rfam-এর 14.10 ও 15.0 সংস্করণও আছে। ফলে গবেষকেরা পরীক্ষায় ব্যবহৃত ডেটাসেটগুলো শনাক্ত করতে পারবেন।
আড়াল করা তথ্য দিয়ে মডেলকে শেখানো
structRFM-এ মাস্কড ল্যাঙ্গুয়েজ মডেলিং ব্যবহার করা হয়েছে। এ পদ্ধতিতে ইনপুটের কিছু অংশ আড়াল করে দেওয়া হয়, আর মডেল আশপাশের প্রসঙ্গ থেকে অনুপস্থিত তথ্য পুনরুদ্ধার করতে শেখে। RNA-র ক্ষেত্রে এর অর্থ শব্দের বদলে নিউক্লিওটাইডগুলোর পারস্পরিক সম্পর্ক শেখা।
গবেষকেরা পেয়ার-ম্যাচিং পদ্ধতির মাধ্যমে এই প্রক্রিয়ায় বেস-পেয়ারিং যুক্ত করেছেন। ডায়নামিক মাস্কিং অনুপাত কাঠামোগত সংযোগনির্ভর প্রশিক্ষণ এবং পৃথক নিউক্লিওটাইড অবস্থান মাস্ক করার মধ্যে ভারসাম্য রাখে। এতে মডেল স্থানীয় সিকোয়েন্স-বিন্যাস এবং ভাঁজের সঙ্গে সম্পর্কিত সংযোগ—দুটিই শেখার সুযোগ পায়।
এর ফলে মডেলটি তিন ধরনের বৈশিষ্ট্য তৈরি করে: পুরো সিকোয়েন্স সম্পর্কে তথ্য, প্রতিটি নিউক্লিওটাইড সম্পর্কে তথ্য এবং নিউক্লিওটাইডের জোড়া সম্পর্কে তথ্য। বৈশিষ্ট্য হলো সংখ্যাভিত্তিক উপস্থাপন, যা অন্য কোনো পূর্বাভাস-ব্যবস্থা ব্যবহার করতে পারে। বিভিন্ন কাজের জন্য এই উপস্থাপনার ভিন্ন ভিন্ন স্তর কাজে লাগানো যায়।
গবেষকেরা অ্যাবলেশন পরীক্ষাও চালিয়েছেন, যেখানে কোনো মডেলের অংশ বাদ দেওয়া বা পরিবর্তন করে তার অবদান যাচাই করা হয়। এসব পরীক্ষা থেকে পাওয়া ফল প্রতিবেদনে উল্লেখিত উন্নতিতে কাঠামোগত তথ্য এবং মাস্কিং কৌশল—দুটিরই অবদান সমর্থন করে। structRFM তৈরির নকশাগত সিদ্ধান্তের পক্ষে এটি প্রমাণ দেয়।
কাঠামো পরীক্ষায় কী দেখা গেছে
শূন্য-শট হোমোলজি শ্রেণিবিন্যাসে structRFM ভালো করেছে। হোমোলজি বলতে অভিন্ন বিবর্তনীয় উৎস থেকে পাওয়া সম্পর্ক বোঝায়। এ ক্ষেত্রে শূন্য-শট শ্রেণিবিন্যাস যাচাই করে, লক্ষ্য শ্রেণিবিন্যাসের কাজে আলাদাভাবে প্রশিক্ষণ না দিয়েও শেখা উপস্থাপনাগুলো এমন সম্পর্ক শনাক্ত করতে কতটা কার্যকর।
লেখকেরা সেকেন্ডারি কাঠামো পূর্বাভাসে উন্নতি এবং সদ্য প্রকাশিত RNA পরিবারের ক্ষেত্রে ভালো কার্যকারিতার কথাও জানিয়েছেন। RNA পরিবার বলতে অভিন্ন সিকোয়েন্স বা কাঠামোগত বৈশিষ্ট্যসম্পন্ন সম্পর্কিত অণুর গোষ্ঠী বোঝায়। সদ্য প্রকাশিত পরিবার দিয়ে পরীক্ষা করলে প্রতিষ্ঠিত ডেটাসেটে থাকা পরিচিত গোষ্ঠীর বাইরে মডেলটি কতটা ভালো কাজ করে, তা বোঝা যায়।
টারশিয়ারি কাঠামো পূর্বাভাসের জন্য দলটি structRFM-এর শেখা বৈশিষ্ট্য ব্যবহার করে Zfold তৈরি করেছে, যা ত্রিমাত্রিক আকৃতি পূর্বাভাস দেয়। পূর্বাভাস করা আকৃতি এবং সেসব পূর্বাভাস থেকে বের করা সেকেন্ডারি কাঠামো—দুটিরই উন্নতির কথা লেখকেরা জানিয়েছেন।
Zfold-কে CASP15-natural, CASP16 এবং RNA-Puzzles-এ মূল্যায়ন করা হয়েছে। আণবিক কাঠামো পূর্বাভাস যাচাইয়ে এসব বেঞ্চমার্ক সংকলন ব্যবহৃত হয়। গবেষণাপত্রে এসব মূল্যায়নে Zfold-এর কার্যকারিতাকে AlphaFold3-এর সঙ্গে তুলনীয় বলা হয়েছে। তুলনাটি ওই নির্দিষ্ট বেঞ্চমার্কগুলোতে Zfold-এর ফল নিয়ে; আর structRFM এর ভিত্তিতে RNA-র উপস্থাপনা সরবরাহ করে।
গবেষণাটিতে সব ধরনের ব্যবহারের জন্য একটিমাত্র নির্ভুলতার স্কোরের বদলে বিভিন্ন ধরনের সাফল্য তুলে ধরা হয়েছে। সম্পর্কিত সিকোয়েন্স শনাক্ত করা, বেস-পেয়ার পূর্বাভাস দেওয়া এবং ত্রিমাত্রিক আকৃতি পুনর্গঠন—এগুলো আলাদা সমস্যা, এবং প্রতিটির জন্য আলাদা মূল্যায়ন প্রয়োজন।
RNA প্রক্রিয়াকরণ থেকে কার্যভিত্তিক শ্রেণিবিন্যাস
RNA কী কাজ করে, সে-সংক্রান্ত কাজেও structRFM পরীক্ষা করা হয়েছে। এর মধ্যে ছিল স্প্লাইস সাইট পূর্বাভাস, ইন্টারনাল রাইবোসোম এন্ট্রি সাইট শনাক্তকরণ এবং নন-কোডিং RNA শ্রেণিবিন্যাস। ফলে মূল্যায়ন শুধু অণুর আকৃতির মধ্যেই সীমাবদ্ধ থাকেনি।
স্প্লাইস সাইট হলো RNA বার্তা প্রক্রিয়াকরণের সময় ব্যবহৃত সীমানা। স্প্লাইসিংয়ের সময় নির্দিষ্ট অংশ বাদ দেওয়া হয় এবং অবশিষ্ট অংশগুলো জুড়ে দেওয়া হয়। এসব সীমানা পূর্বাভাস করতে পারলে প্রোটিন তৈরিতে ব্যবহারের আগে জিনগত বার্তা কীভাবে গঠিত হয়, তা গবেষকেরা পরীক্ষা করতে পারেন।
ইন্টারনাল রাইবোসোম এন্ট্রি সাইট বা IRES উপাদান হলো RNA-র এমন অঞ্চল, যা প্রোটিন তৈরির জন্য দায়ী কোষীয় যন্ত্রপাতিকে ভেতরের কোনো স্থান থেকে অনুবাদ শুরু করতে দেয়। এগুলো শনাক্ত করতে সিকোয়েন্সের ভেতরের কার্যকর বিন্যাস চিনতে হয়। তাই প্রি-ট্রেনিংয়ের সময় শেখা তথ্যের এটি আরেকটি পরীক্ষা।
নন-কোডিং RNA প্রোটিন তৈরির নকশা হিসেবে কাজ করা ছাড়াও বিভিন্ন ভূমিকা পালন করে। এগুলোর শ্রেণিবিন্যাসের অর্থ হলো অণুগুলোকে প্রাসঙ্গিক গোষ্ঠীতে ভাগ করা। লেখকেরা এসব কার্যভিত্তিক কাজে উন্নত ফলের কথা জানিয়েছেন। এতে দেখা যায়, পূর্বাভাসের লক্ষ্য কাঠামো থেকে জৈবিক ভূমিকার দিকে বদলালেও শেখা উপস্থাপনাগুলো কার্যকর ছিল।
দলটি সেগমেন্টেশন কৌশল ব্যবহার করে দীর্ঘ নন-কোডিং RNA শ্রেণিবিন্যাসের কাজেও মডেলটি সম্প্রসারিত করেছে। দীর্ঘ সিকোয়েন্সকে কয়েকটি অংশে ভাগ করলে এমন ইনপুটে মডেলটি প্রয়োগ করা যায়, যা একক হিসেবে প্রক্রিয়াকরণ করা কঠিন হতো।
উন্মুক্ত প্রকাশনা গবেষকদের কী দিচ্ছে
প্রকাশনায় তিন ধরনের উপকরণ রয়েছে, যেগুলোর ব্যবহার আলাদা। ডেটাসেটে শেখার উদাহরণগুলো রয়েছে। মডেলের ওজনে প্রশিক্ষণের সময় শেখা সংখ্যাগত মানগুলো থাকে। সোর্স কোডে সফটওয়্যার কীভাবে বাস্তবায়ন ও চালাতে হয় তা বর্ণনা করা হয়েছে।
ওজন ব্যবহারের সুযোগ থাকায় গবেষকেরা পুরো প্রি-ট্রেনিং প্রক্রিয়া আবার না চালিয়ে আগে থেকেই প্রশিক্ষিত মডেল নিয়ে কাজ করতে পারবেন। ডেটা ও কোড পাওয়া গেলে প্রশিক্ষণ-পদ্ধতি আরও নিবিড়ভাবে পরীক্ষা, পরীক্ষা-নিরীক্ষা পুনরুৎপাদন এবং বিকল্প পদ্ধতি তৈরি করা সম্ভব হবে।
গবেষণাপত্রে প্রকল্পটির GitHub রিপোজিটরির নাম heqin-zhu/structRFM দেওয়া হয়েছে। প্রি-ট্রেনিং ডেটাসেটের জন্য Zenodo আর্কাইভের DOI 10.5281/zenodo.18272040 এবং সোর্স কোড ও মডেল চেকপয়েন্টের আর্কাইভের DOI 10.5281/zenodo.18274292-ও উল্লেখ করা হয়েছে। DOI হলো একটি স্থায়ী শনাক্তকারী, যার উদ্দেশ্য গবেষণা-উপকরণকে দীর্ঘ সময় ধরে শনাক্তযোগ্য রাখা।
ডেটা-সংক্রান্ত বিবৃতিতে বলা হয়েছে, প্রশিক্ষণ ও পরীক্ষার ডেটাসেট প্রকল্পের রিপোজিটরিতে সবার জন্য উন্মুক্ত। গবেষণায় ব্যবহৃত IRES-এর প্রক্রিয়াজাত বিভাজন এবং চিত্রগুলোর পেছনের উৎস-ডেটাও দেওয়া হয়েছে। লেখকেরা জানিয়েছেন, ডেটা পাওয়ার ক্ষেত্রে কোনো বিধিনিষেধ নেই।
তুলনামূলক মূল্যায়নের জন্য এসব তথ্য গুরুত্বপূর্ণ। গবেষকেরা কোন ডেটাসেট ও বিভাজন ব্যবহার করা হয়েছে তা যাচাই করতে, মূল্যায়ন আবার চালাতে এবং প্রশিক্ষণের অন্য কোনো সিদ্ধান্তে ফল বদলায় কি না পরীক্ষা করতে পারবেন। ফলে এই প্রকাশনা মডেলটি পুনর্ব্যবহারের পাশাপাশি গবেষণার ফল যাচাইয়েও সহায়তা করে।
গবেষক দল ও প্রকাশনার সময়রেখা
কাজটি USTC-এর স্কুল অব বায়োমেডিক্যাল ইঞ্জিনিয়ারিং এবং মেডিক্যাল ইমেজিং, রোবোটিকস, অ্যানালিটিক কম্পিউটিং অ্যান্ড লার্নিং ল্যাবরেটরির মাধ্যমে পরিচালিত হয়েছে, যা MIRACLE নামে পরিচিত। লেখকদের অধিভুক্ত প্রতিষ্ঠানের মধ্যে হেফেই এবং USTC-এর সুচৌ ইনস্টিটিউট ফর অ্যাডভান্সড রিসার্চ রয়েছে। সহলেখক রুইফেং লি হাংজৌয়ে ঝেজিয়াং বিশ্ববিদ্যালয়ের কলেজ অব কম্পিউটার সায়েন্স অ্যান্ড টেকনোলজির সঙ্গে যুক্ত।
অধ্যাপক ঝৌ এবং বিশেষ গবেষণা ফেলো শিয়ং গবেষণার পরিকল্পনা করেন ও তত্ত্বাবধান করেন। ঝু কাঠামোটি নকশা ও বাস্তবায়ন করেন, প্রি-ট্রেনিং পরিচালনা করেন এবং কাঠামো পূর্বাভাস ও RNA শ্রেণিবিন্যাসের একাধিক পরীক্ষা চালান। তিনি ফলাফলও বিশ্লেষণ করেন। দলের অন্য সদস্যরা হোমোলজি পরীক্ষা, ডেটাসেটের তুলনা, IRES শনাক্তকরণ এবং কাঠামোগত মূল্যায়নে কাজ করেন।
গবেষণাটির প্রকাশনা ও জনসমক্ষে উপস্থাপন দুটি ক্যালেন্ডার তারিখে ঘটেছে:
- ৪ নভেম্বর ২০২৬: Nature-এ An open structure-guided RNA foundation model for generalizable prediction শীর্ষক গবেষণাপত্রের প্রকাশনা তালিকাভুক্ত হয়।
- ৫ নভেম্বর ২০২৬: চীনে গবেষণা ও এর উন্মুক্ত প্রকাশনার খবর প্রকাশ করা হয়। অনলাইন প্রকাশনাটি ভোরের দিকে হয়েছে বলে বর্ণনা করা হয়।
লেখকেরা চীনের ন্যাশনাল ন্যাচারাল সায়েন্স ফাউন্ডেশন, ন্যাশনাল কি R&D প্রোগ্রাম, জিয়াংসু ও সুচৌয়ের গবেষণা কর্মসূচি এবং শেনঝেনে সানমিং প্রজেক্ট অব মেডিসিনের সহায়তার কথা জানিয়েছেন। তাঁরা কোনো স্বার্থের সংঘাত নেই বলে ঘোষণা করেছেন।
RNA গবেষণায় ফলাফলগুলোর প্রভাব
structRFM বিভিন্ন গবেষণা কার্যক্রমের জন্য একটি অভিন্ন সূচনাবিন্দু তৈরি করেছে। RNA প্রক্রিয়াকরণ নিয়ে কাজ করা কোনো গবেষণাগার একই ভিত্তি মডেল নিজেদের মতো মানিয়ে নিতে পারে, যা অন্য কোনো দল ভাঁজ নিয়ে গবেষণা বা নন-কোডিং অণুর শ্রেণিবিন্যাসে ব্যবহার করছে। তবে প্রতিটি প্রয়োগের জন্য নিজস্ব কাজভিত্তিক উন্নয়ন ও মূল্যায়ন প্রয়োজন।
২ কোটি ১০ লাখ প্রশিক্ষণ জোড়া, কাঠামো-নির্দেশিত শিক্ষা এবং প্রকাশিত চেকপয়েন্টের সমন্বয়ে গবেষকেরা শুধু অ্যালগরিদমের বিবরণ নয়, পরীক্ষা করার মতো একটি বাস্তব সিস্টেম পাচ্ছেন। MUSES এবং মাস্কিং-সংক্রান্ত পরীক্ষাগুলোও নির্দিষ্ট নকশাগত সিদ্ধান্ত তুলে ধরে, যা অন্য দলগুলো পরীক্ষা বা পরিবর্তন করতে পারে।
প্রতিবেদিত ফলাফলগুলো গণনাভিত্তিক পূর্বাভাস ও শ্রেণিবিন্যাসকেন্দ্রিক। বায়োমেডিক্যাল প্রয়োগের দিকে এগোতে হলে আরও জৈবিক পরীক্ষা প্রয়োজন হবে, যার মধ্যে পূর্বাভাস করা কাঠামো যাচাই এবং নির্দিষ্ট RNA অণুর জন্য নির্ধারিত কার্য পরীক্ষা করা অন্তর্ভুক্ত।
গবেষণাপত্রে ক্লিনিক্যাল প্রয়োগের কোনো সময়সীমা দেওয়া হয়নি। তাৎক্ষণিক পরিবর্তন হলো, এখন বিশ্বের গবেষকেরা প্রশিক্ষণ-উপকরণ সংগ্রহ, বাস্তবায়ন পরীক্ষা এবং নিজেদের RNA ডেটাসেটে প্রতিবেদিত উন্নতি পাওয়া যায় কি না, তা যাচাই করতে পারবেন।
মূল বিষয়গুলো
- USTC-এর গবেষকেরা structRFM প্রকাশ করেছেন। এটি প্রায় ২ কোটি ১০ লাখ সিকোয়েন্স ও সেকেন্ডারি কাঠামোর জোড়া দিয়ে প্রশিক্ষিত RNA ফাউন্ডেশন মডেল।
- মডেলটি সিকোয়েন্সের বিন্যাস ও বেস-পেয়ারিংয়ের সম্পর্ক শেখে, এরপর শুধু সিকোয়েন্স ইনপুট থেকেই বৈশিষ্ট্য তৈরি করে।
- MUSES কাঠামোগত পূর্বাভাসের বিভিন্ন উৎস একত্র করে, আর ডায়নামিক মাস্কিং প্রশিক্ষণের সময় কাঠামোগত ও নিউক্লিওটাইড-সংক্রান্ত তথ্যের মধ্যে ভারসাম্য রাখে।
- লেখকেরা হোমোলজি শ্রেণিবিন্যাসে ভালো ফল এবং সেকেন্ডারি কাঠামো পূর্বাভাসে উন্নতির কথা জানিয়েছেন; সদ্য প্রকাশিত RNA পরিবারেও পরীক্ষা চালানো হয়েছে।
- টারশিয়ারি কাঠামো পূর্বাভাসের জন্য তৈরি অভিযোজিত মডেল Zfold তিনটি নির্দিষ্ট বেঞ্চমার্ক সংকলনে AlphaFold3-এর সঙ্গে তুলনীয় ফল করেছে বলে জানানো হয়েছে।
- ডেটাসেট, মডেলের ওজন, সোর্স কোড ও মূল্যায়নের উপকরণ পুনর্ব্যবহার ও গবেষণা পুনরুৎপাদনের জন্য সবার কাছে উন্মুক্ত।